关注
【数据结构6】排序(Python)
🗓 2018年11月20日 📁 文章归类: 0x80_数据结构与算法
版权声明:本文作者是郭飞。转载随意,标明原文链接即可。
原文链接:https://www.guofei.site/2018/11/20/sort.html
0. 评价标准
- 时间复杂度
- 空间复杂度
- 稳定性(指的是,当两个元素的Key相等时,排序之前前面的元素,在排序之后仍然出现在前面)
| 排序方法 | 原理 | 最好时间 | 平均时间 | 最坏时间 | 空间复杂度 | 稳定性 |
|---|---|---|---|---|---|---|
| 冒泡排序 | 反复交换相邻逆序元素 | O(n) | O(n^2) | O(n^2) | O(1) | 稳定 |
| 直接插入法 | 把元素插入到左侧已排序不分 | O(n) | O(n^2) | O(n^2) | O(1) | 稳定 |
| 希尔排序 | 按间隔分组,组内做直接插入排序,逐步减少组数 | O(n^1.333) | O(n^2) | O(1) | 不稳定 | |
| 直接选择排序 | 每轮把最小值放到当前池前面 | O(n^2) | O(n^2) | O(n^2) | O(1) | 不稳定 |
| 快速排序 | 划分+递归 | O(nlogn) | O(nlogn) | O(n^2) | O(logn) | 不稳定 |
| 归并排序 | O(nlogn) | O(nlogn) | O(nlogn) | O(n) | 稳定 | |
| 堆排序 | O(nlogn) | O(nlogn) | O(nlogn) | O(1) | 不稳定 | |
| 桶排序 | 先按照区间分桶,桶内排序后拼接 | O(n+k) | ||||
| 基数排序 | O(mn) | O(mn) | O(mn) | O(mn) | 稳定 |
0.1 测试数据
我们把排序的对象抽象成 DataType 数据类型,之后会使用key作为排序的目标
class DataType:
    def __init__(self, key, value):
        self.key = key
        self.value = value

    def __repr__(self):
        return 'key:{key},value:{value}'.format(key=self.key, value=self.value)

data = [DataType(64, 'data1'), DataType(5, 'data2'), DataType(7, 'data3'), DataType(89, 'data4'),
     DataType(6, 'data5'),DataType(24, 'data6'), DataType(24, 'data7')]
1. 平方级复杂度
1.1 冒泡排序
核心思想:比较相邻元素,逆序就交换。每完成一趟,当前最大值就会移动到最右端。
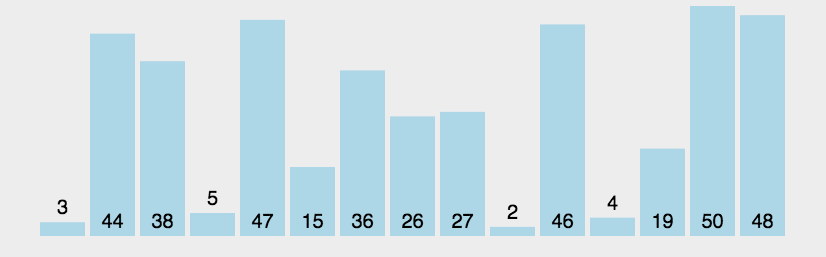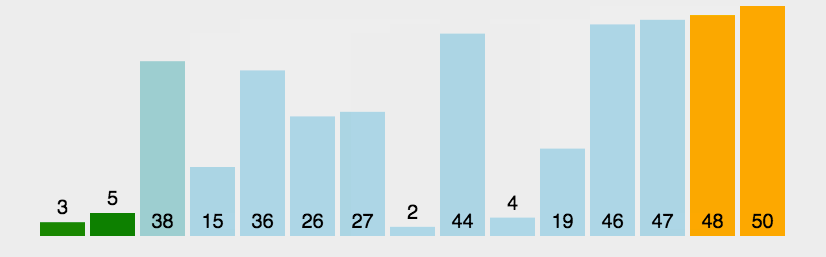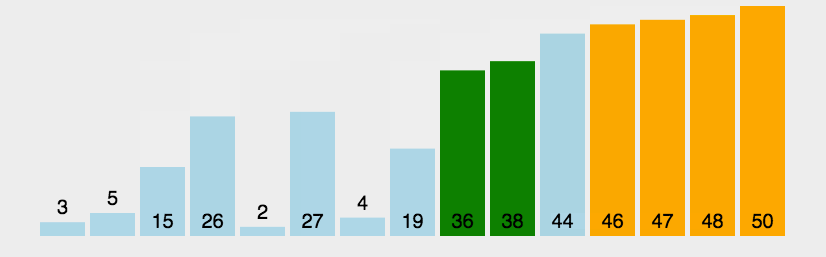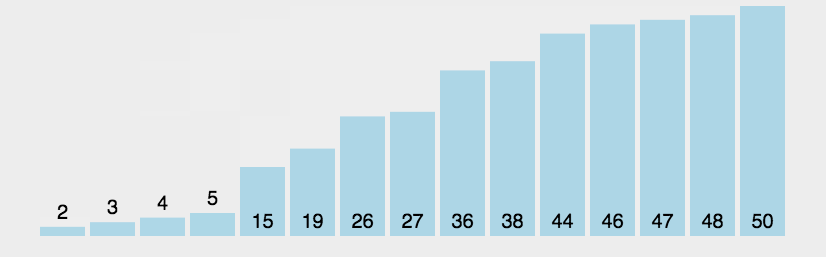
- 比较相邻的元素。如果第j个比第j+1个大,就交换它们两个;
- 对每一对相邻元素作同样的工作,从开始第一对到结尾的最后一对,这样在最后的元素应该会是最大的数;
- 针对所有的元素重复以上的步骤,除了最后一个;
- 重复步骤1~3,直到排序完成。
def bubble_sort1(arr):
    for i in range(len(arr) - 1):
        for j in range(len(arr) - i - 1):
            if arr[j] > arr[j + 1]:
                arr[j], arr[j + 1] = arr[j + 1], arr[j]


#%% 测试正确性
import random

n = 10
arr = list(range(n))
random.shuffle(arr)

bubble_sort1(arr)

assert arr == list(range(n))
优化1:如果一轮循环都没发生交换,可以提前结束。
def bubble_sort2(arr):
    for i in range(len(arr) - 1):
        is_sorted = True
        for j in range(len(arr) - i - 1):
            if arr[j] > arr[j + 1]:
                arr[j], arr[j + 1] = arr[j + 1], arr[j]
                is_sorted = False

        if is_sorted:
            break
优化2:
- 第i次循环后,最后i+1个元素一定是已经排好序的,之后不再参与变化(原始算法也有体现)。
- 但,末尾已经排好序的数量可能多于 i+1 个。这就又有优化空间了
- 方法:记录下每一轮排序后,最后一个发生元素交换的位置,这个元素之后的位置其实就是已经排好序的位置了,之后不再遍历
def bubble_sort3(arr):
    last_exchange_idx_tmp, last_exchange_idx = 0, len(arr) - 1
    for i in range(len(arr) - 1):
        for j in range(last_exchange_idx):
            if arr[j] > arr[j + 1]:
                arr[j], arr[j + 1] = arr[j + 1], arr[j]
                last_exchange_idx_tmp = j
        last_exchange_idx = last_exchange_idx_tmp
优化3:鸡尾酒排序
- 方法:交替进行,从左到右冒泡,下一轮从右往左冒泡,下下一轮又从左往右冒泡,以此类推
- 适用场景:大多数元素已有序,但位置未必正确。例如
2,3,4,5,6,7,8,1,冒泡排序怎样都要8轮,但鸡尾酒排序只需要2轮
1.2 直接插入排序
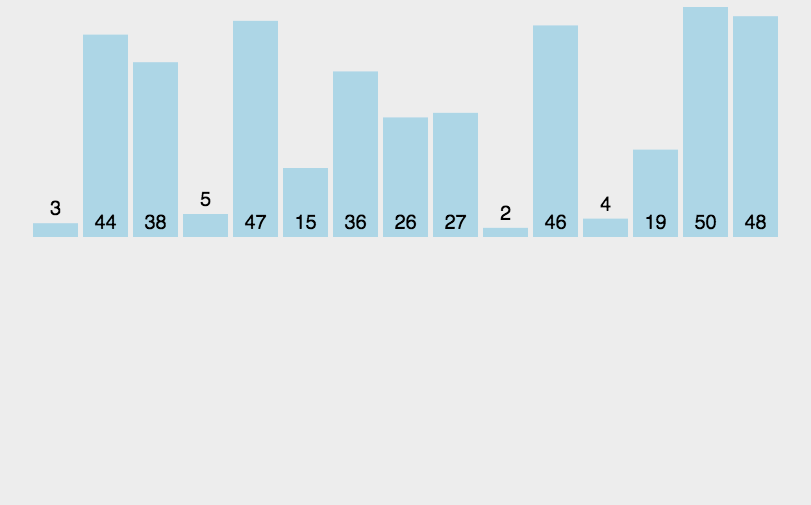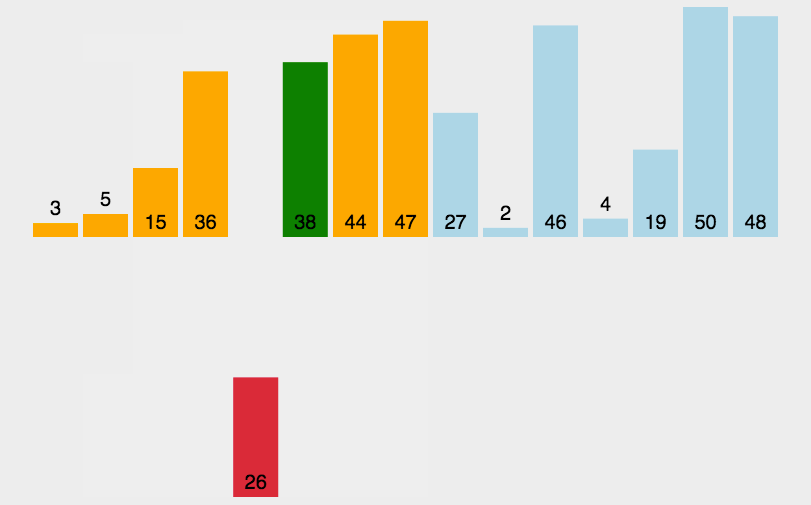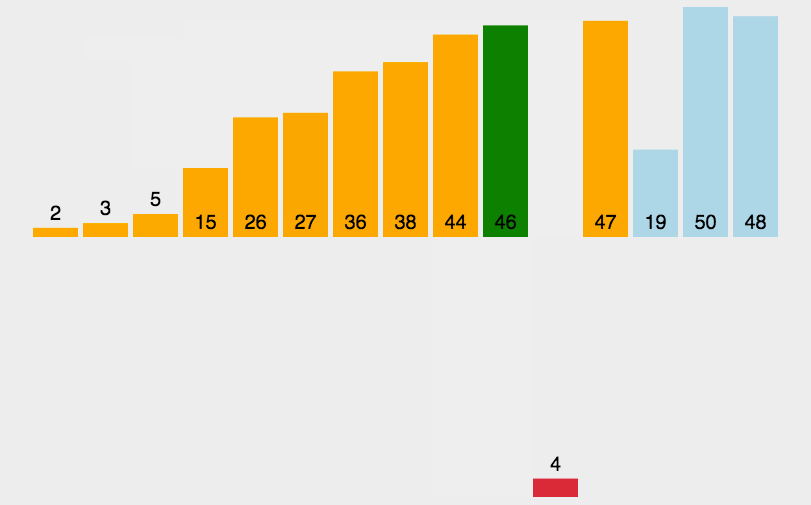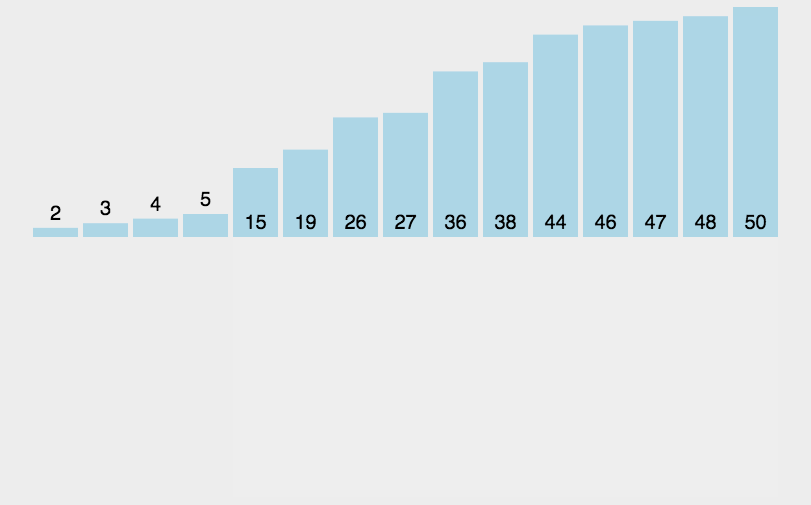
核心思想:左侧是已有序部分。每次在右侧取一个元素,插入到左侧的正确位置。
算法
- 从第一个元素开始,该元素可以认为已经被排序;
- 取出下一个元素,在已经排序的元素序列中从后向前扫描;
- 如果该元素(已排序)大于新元素,将该元素移到下一位置;
- 重复步骤3,直到找到已排序的元素小于或者等于新元素的位置;
- 将新元素插入到该位置后;
- 重复步骤2~5。
def InsertSort(data):
    len_data = len(data)
    for i in range(len_data - 1):
        tmp = data[i + 1]
        j = i
        while (j > -1) and (tmp.key < data[j].key):
            data[j + 1] = data[j]
            j -= 1
        data[j + 1] = tmp
    return data
- 时间复杂度
- 最好复杂度。已经完成排序的序列,比较次数n-1,赋值次数2(n-1),复杂度$O(n)$
- 最坏复杂度。原序列是反序排列,复杂度是$O(n^2)$
- 平均复杂度。原序列随机排列,复杂度是$O(n^2/4)=O(n^2)$
- 空间复杂度$O(1)$
- 稳定性:稳定
1.3 希尔排序
思路:把待排序数据分为 n 个组(间隔为k),每个组内用 直接插入排序;小组个数逐步缩小,每次都用 直接插入排序 重新排序;直到只剩 1个组为止。
希尔排序有效的原因:
- 数组越接近有序,直接插入排序的效率就越高。
- 从另一个角度理解:先用较大步长,使元素一次跨越多个位置。从而减少数据移动操作
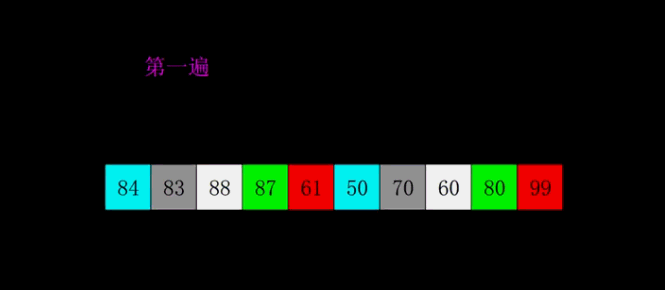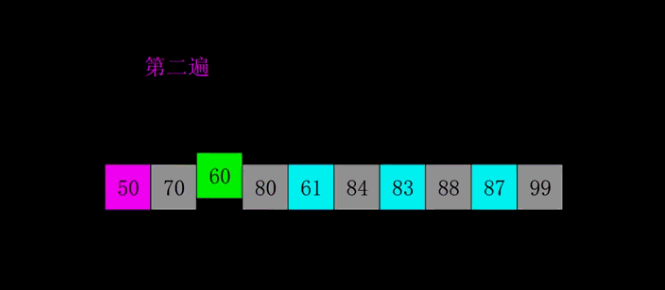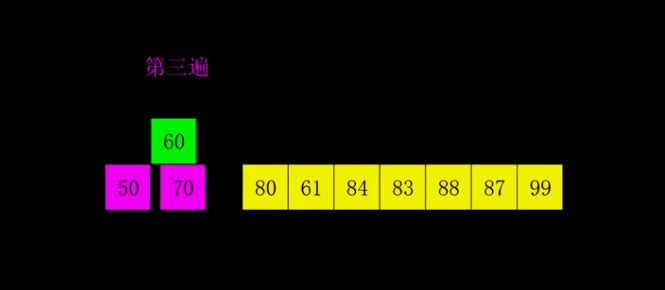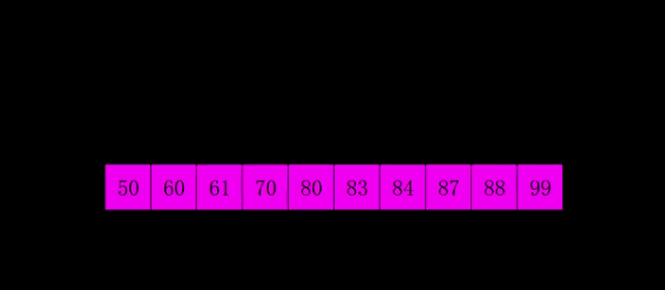
- 选择一个增量序列t1,t2,…,tk,其中ti>tj,tk=1;
- 按增量序列个数k,对序列进行k 趟排序;
- 每趟排序,根据对应的增量ti,将待排序列分割成若干长度为m 的子序列,分别对各子表进行直接插入排序。
- 仅增量因子为 1 时,整个序列作为一个表来处理,表长度即为整个序列的长度。
1.4 直接选择排序
核心思想:左边是已排序部分,右边是待排序部分。每次从右边找到最小值,将它放到左边的末位。
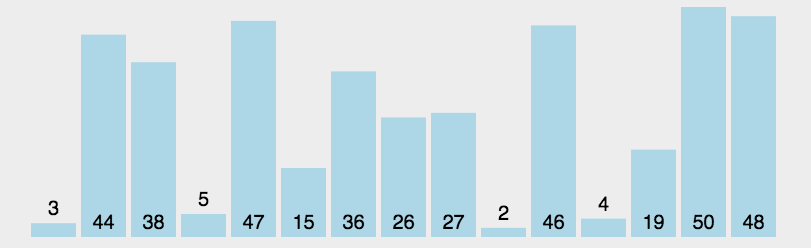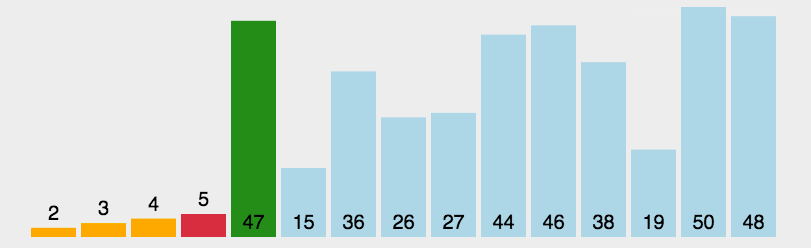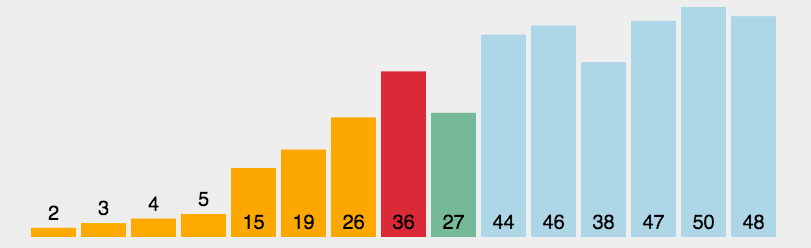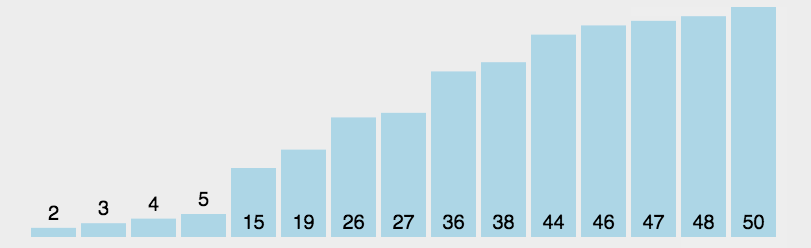
思路:每次在池子中选择一个最小的,放到序列前面
- 初始状态:无序区为R[1..n],有序区为空;
- 第i趟排序(i=1,2,3…n-1)开始时,当前有序区和无序区分别为R[1..i-1]和R(i..n)。该趟排序从当前无序区中-选出关键字最小的记录 R[k],将它与无序区的第1个记录R交换,使R[1..i]和R[i+1..n)分别变为记录个数增加1个的新有序区和记录个数减少1个的新无序区;
- n-1趟结束,数组有序化了。
def SelectSort(data):
    len_data = len(data)
    for i in range(len_data - 1):
        min_index = i
        for j in range(i + 1, len_data):  # 找到之后最小的
            if data[j].key < data[min_index].key:
                min_index = j
        if min_index != i:  # 如果最小的还是最开始的那个,不进行交换
            data[min_index], data[i] = data[i], data[min_index]
    return data
2. nlogn 复杂度
2.1 快速排序
快速排序是一种基于二叉树的交换排序算法
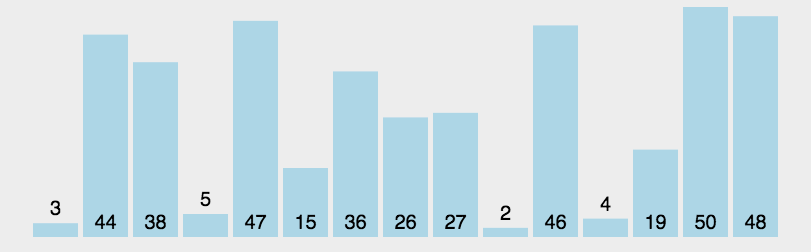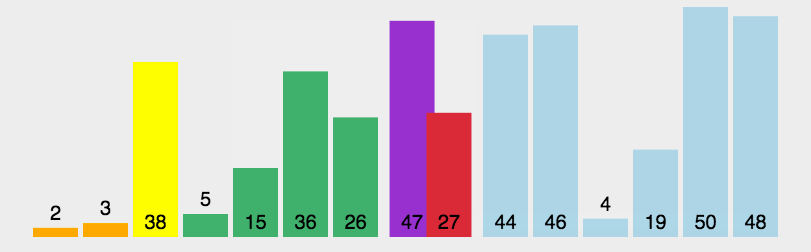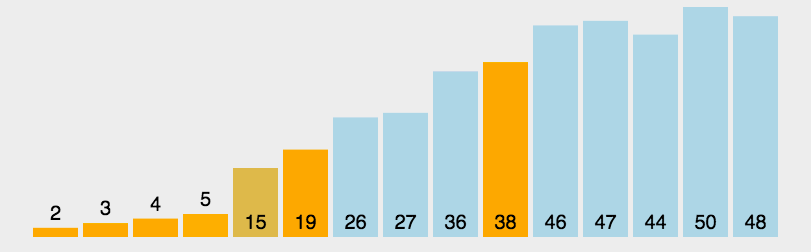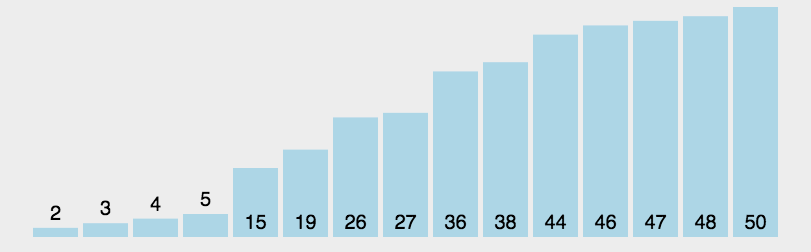
快排思路
- 找一个基准值
- 使小于基准值的放到左边,大于基准值p的放到右边
- 上面得到了2个子列,对每个子列重复1,2
那么第二步如何实现呢?
- 两个指针指向两个端点,序号分别是i,j,后面的算法两个指针向中间移动
- 把基准值p拿出来,这样链上有个空位。例如,选左端点为p,这样i就是空位
- 右指针j向左移动,如果遇到比p小的,就填到空位i上。然后j就变成空位(看成空位,实际不必替换)。
- 如果i是空位,j向左移动;如果j是空位,i向右移动
- 直到i==j,然后把p填到i上
- 完成
def quick_sort(start_idx, end_idx, arr):
    if start_idx >= end_idx:
        return
    pivot_idx = partition(start_idx, end_idx, arr)
    quick_sort(start_idx, pivot_idx - 1, arr)
    quick_sort(pivot_idx + 1, end_idx, arr)


def partition(start_idx, end_idx, arr):
    # 这里用最左边为pivot;也可以先随机找一个值,与第一个交换,达成随机 pivot 的目的
    pivot = arr[start_idx]
    left, right = start_idx, end_idx
    hole = 0  # 0:代表 left 是空洞;1:代表right是空洞
    while left < right:
        if hole == 0:
            if arr[right] < pivot:
                arr[left] = arr[right]
                hole = 1
                left += 1
            else:
                right -= 1
        else:
            if arr[left] >= pivot:
                arr[right] = arr[left]
                hole = 0
                right -= 1
            else:
                left += 1
    arr[left] = pivot
    return left
2.2 堆排序
构建二叉堆
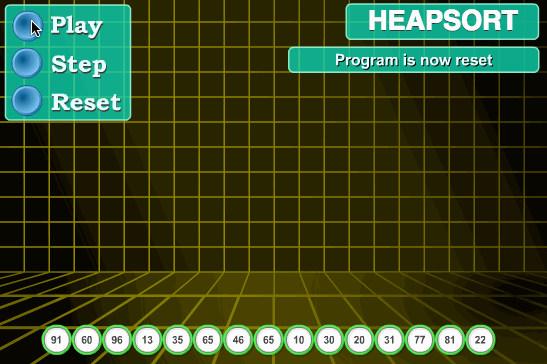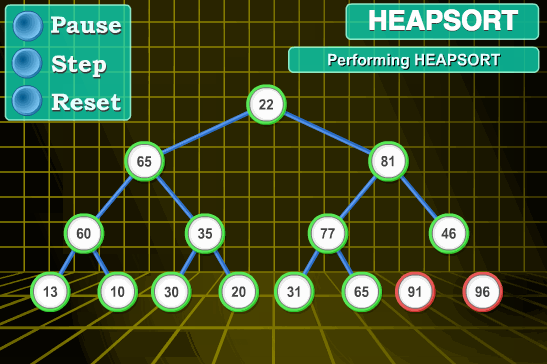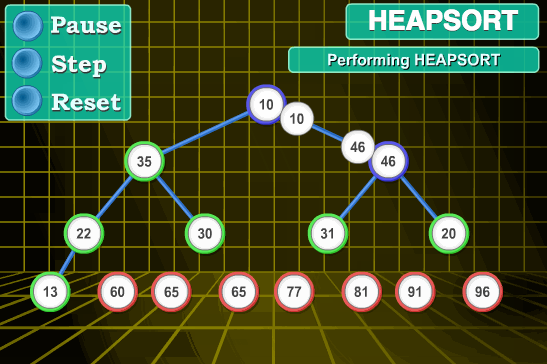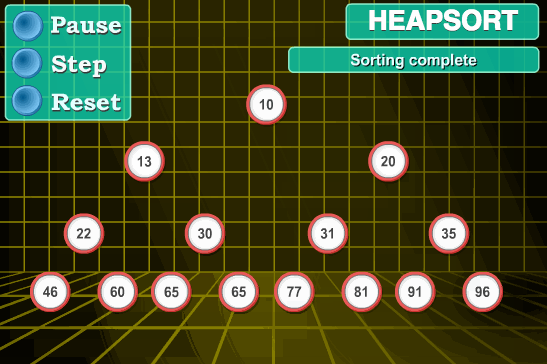
# heapq 有现成的方案
import heapq
def HeapSort(data):
    heapq.heapify(data)  # O(n)
    res = []
    while data:
        res.append(heapq.heappop(data))
    return res

HeapSort([[3, 9], [5, 2], [7, 9], [1, 3], [3, 5]])
2.3 归并排序
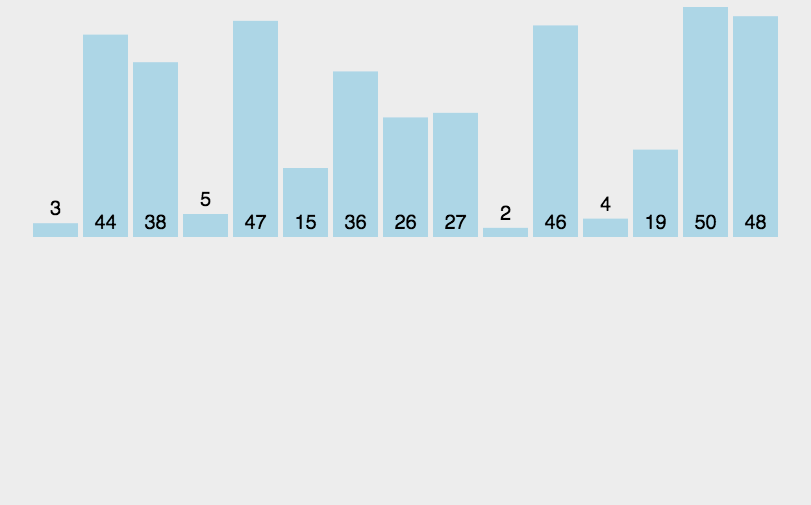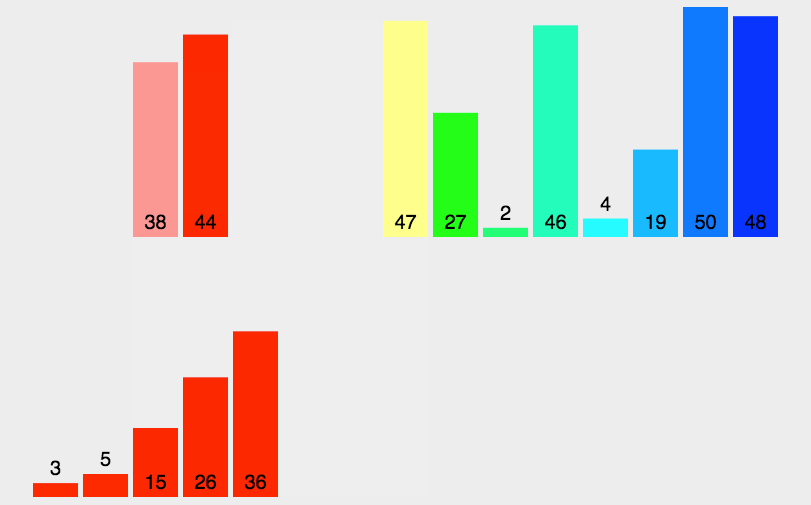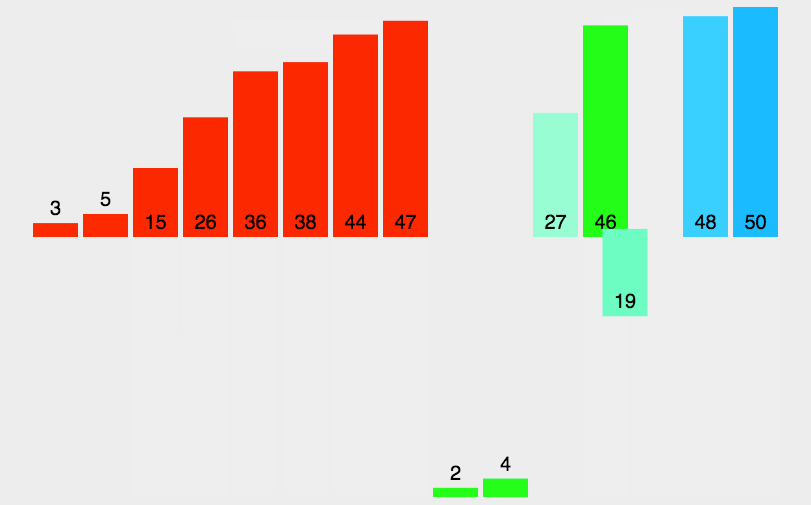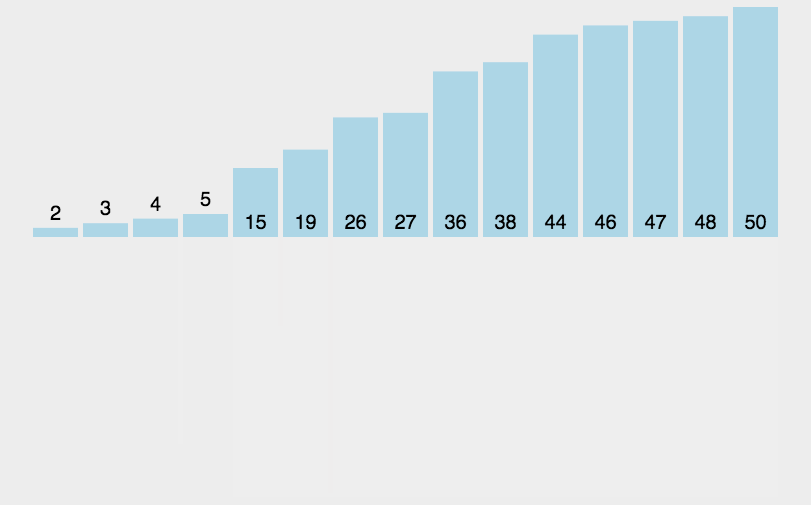
- 把长度为n的输入序列分成两个长度为n/2的子序列;
- 对这两个子序列分别采用归并排序(触发递归);
- 将两个排序好的子序列合并成一个最终的排序序列。
3. 利用数据特征的排序
数据有特殊的特征,甚至可以优化到线性复杂度
3.1 计数排序
适用情况:取值范围为有限个整数,例如,有100万个数字,它们都是 0 到 9 的整数,要求排序
核心思想:不直接比较元素,而是统计每个整数出现了几次,再按照整数从小到大的顺序写回。
算法:循环一次记数,再循环一次把数字填回去
def count_sort(arr):
    # 计数
    counter = [0] * (max(arr) + 1)
    for val in arr:
        counter[val] += 1

    # 填充
    i = 0
    for val, cnt in enumerate(counter):
        for _ in range(cnt):
            arr[i] = val
            i += 1


import random

n = 10000
arr = [random.randint(0, 9) for i in range(n)]
count_sort(arr)
assert arr == sorted(arr)
3.2 桶排序
核心思想:把取值范围划分为几个连续区间,每个数分桶,各桶内部排序后拼接。
算法步骤
- 按照全局取之范围,将其划分为n个区间(n个桶)
- 遍历arr,把元素放入桶内
- 每个桶内做排序
算法复杂度
- 最好的情况:n个元素,均匀分到n个桶内。时间复杂度 On,空间复杂度 On
- 最坏的情况:极不均匀,大多数元素被分到同一个桶内,退化为快排,时间复杂度为O(nlogn),空间复杂度为 On(比快排浪费)
基数排序 是桶排序的一种特例
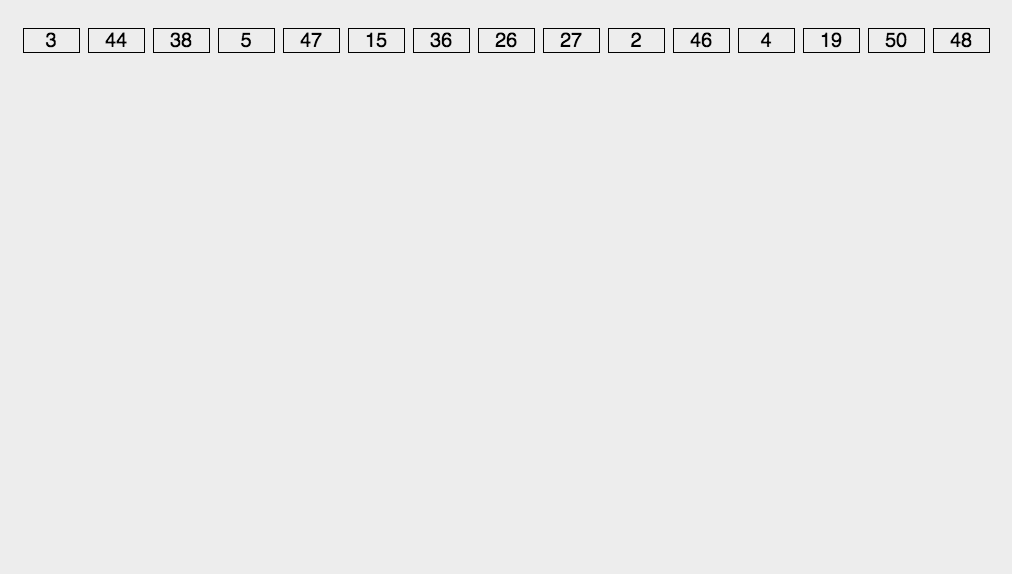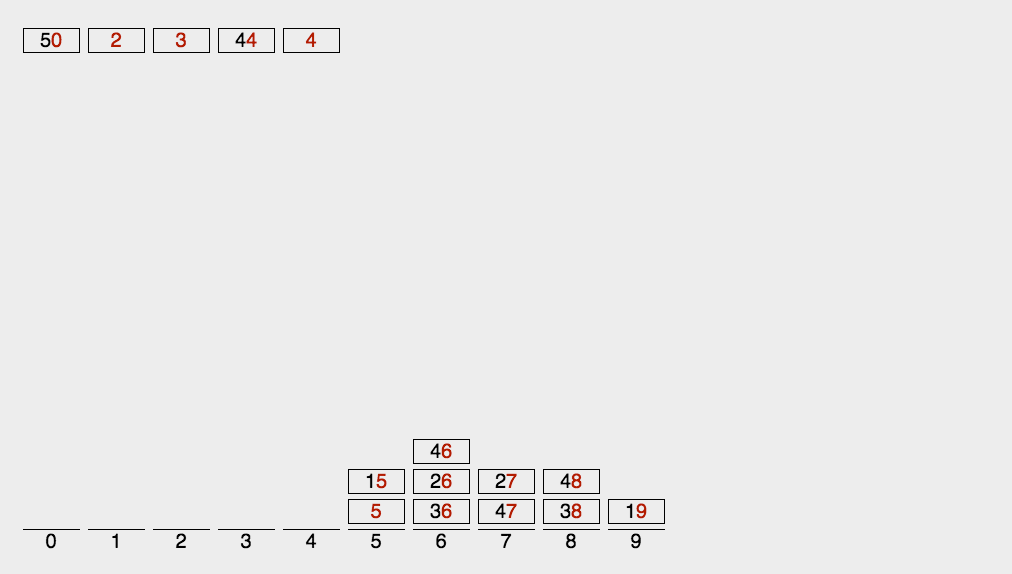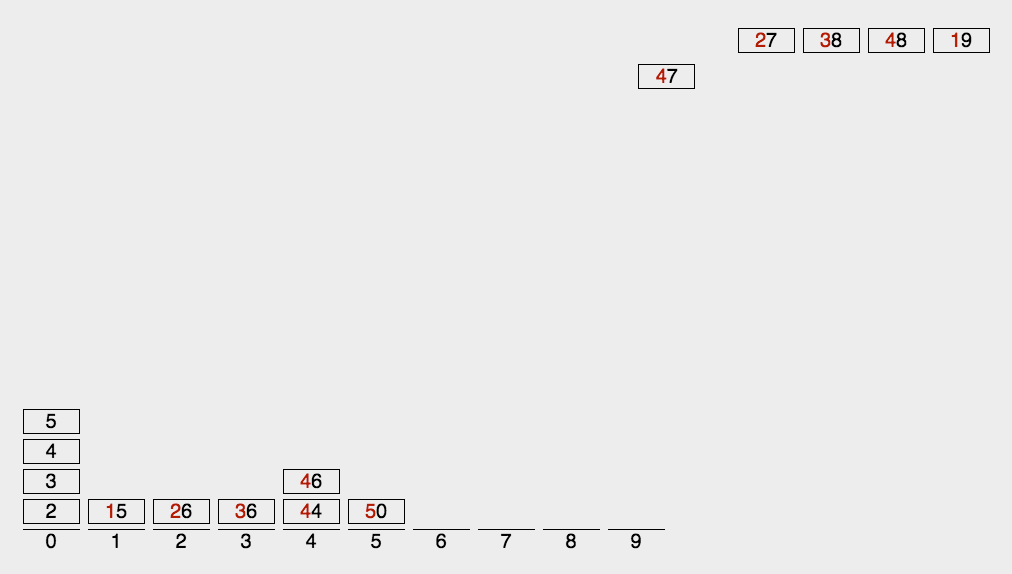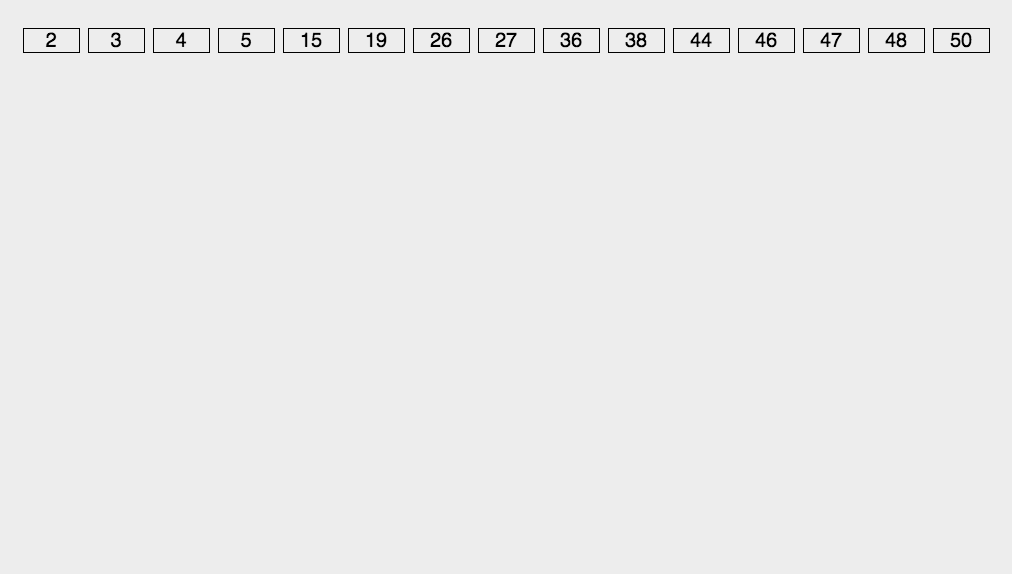
6. 大规模数据排序
2G内存,如何给20亿个int数据(8G)排序?
- 把8G数据分4片,每一片做排序
- 对于每片,每次读取1个值,比较后输出
- 这个题目有4片,n片的话第二步可以用堆排序
参考文献
朱战立:《数据结构-使用C语言》,西安交通大学出版社
https://www.cnblogs.com/onepixel/articles/7674659.html
您的支持将鼓励我继续创作!