关注
📖 计算机网络
概述
计算机网络定义:互连、自治 的计算机集合
- 自治:无主从关系
- 互联
最大的计算机网络:Internet
网络协议(network protocol),三要素:
- 语法(Syntax)
- 数据与控制信息的结构或格式
- 如果是底层设备,定义的是信号电平
- 语义(Semantics)
- 需要发出何种信息
- 完成何种动作,做出何种响应
- 差错控制
- 时序(Timing)
- 事件顺序
- 速度匹配
物理介质
- DSL:电话线
- 50kHz-1MHz 用于下行
- 4kHz-50kHz 用于上行
- 0kHz-4kHz 用于传统电话
- 电缆网络(电视线)
- HFC(混合光纤同轴电缆,hybrid fiber coaxial)
- 下行 30Mbps,上行 2Mbps
- 光纤
- 移动网络(4G/5G)
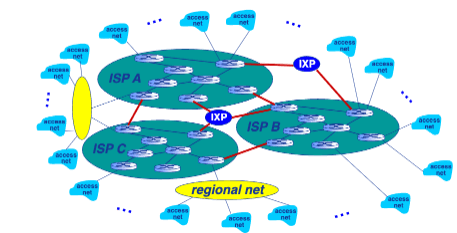
internet 结构
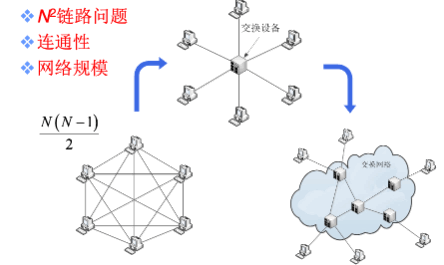
两两相连是不可能的
- 共需要 N^2 条线路,成本极高
- 每台机器需要连接 N-1 条线路,不可能
数据交换
数据交换:如何在多个设备之间传输数据
- 电路交换(circuit switching):建立一条专用物理电路。
- 通信质量稳定、线路利用率低
- 典型例子:电话网络
- 典型特点:独占资源
- 经常用 多路复用(multiplexing)技术 来提高用户容量。
- 报文交换(message switching):每个报文是一个信息单元(报头+报文主体+报尾),网络中每个中间节点会接收完整的报文,然后根据报头往下转发。
- 延迟大、线路利用率高。
- 典型例子:电报
- 分组交换(packet switching):报文 分成若干个 packet,每个有自己的头,在网络中独立转发,在目的地整合。高效、灵活、充分利用网络资源,需要复杂的协议。
- 目前互联网最常用
- 与报文交换相比。每个中间节点无需等待整个报文接收完毕再转发,而是接收每个 packet 后转发,这使得 交付时间大大减少,所需缓存大大减少
- 与电路交换相比。大大提高用户数量。
- 例如,链路1Mb/s,每个用户需要 100kb/s,活跃时间10%。如果使用电路交换,不活跃时间内不能解除电路独占,因此一个线路能容纳的用户数量为 10个;如果使用使用分组交换,如果有 35个用户,同时有大于10个活动的概率为万分之四
- 分组交换适用于 突发 数据传输,这也是现代网络的特点。
- 可能产生拥塞(congestion),分组的延迟和丢失
多路复用: 把链路划分为“片”,使得可以多路独占“片”进行通信
- 频分多路复用(frequency division multiplexing,FDM)
- 每个用户占用 频率带宽(Hz),始终用对应的频率来通信
- 例如有线电视信号
- 时分多路复用(time division multiplexing,TDM)
- 按照时间等长划分,称为 帧,每个帧等长划分为多个 时隙。每个用户占用一个时隙,周期性使用链路
- 波分多路复用(Wavelength division multiplexing,WDM)
- 实际上是一种 FDM,光通信中通常用波长来描述,故而另写一类
- 码分多路复用(Code division multiplexing,CDM)
- 广泛用于无线链路共享(蜂窝网络、卫星通信等)
- 每个用户分配一个唯一的 m bit 码片序列 (chipping sequence),各用户之间的 码片序列 相互 正交(orthogonal)
- 各用户使用相同频率载波,利用各自码片序列编码数据。
- 信道上各个用户同时发送信息,这些信息会叠加。解码时用对应的码片序列解码即可
- CDMA
码分多路复用 算法挺有趣,我用python写了一下
import numpy as np


def is_orthogonal(chipping1, chipping2) -> bool:
    # 确保正交
    dot_sum = np.sum(chipping1 * chipping2)
    return dot_sum == 0


def encode(msg, chipping):
    res = list()
    for i in msg:
        res.extend((i * chipping).tolist())

    return np.array(res)


def mix(p1, p2):
    return p1 + p2


def decode(p, chipping):
    length_chipping = len(chipping)
    length = len(p) // length_chipping

    res = []
    for i in range(length):
        p_slice = p[i * length_chipping:(i + 1) * length_chipping]
        if np.mean(p_slice * chipping) > 0:
            p_val = 1
        elif np.mean(p_slice * chipping) < 0:
            p_val = -1
        else:
            p_val = 0  # 表示没有传递数据
        res.append(p_val)
    return res


msg1 = [-1, 1, 1, 1, -1]
msg2 = [1, -1, -1, 1, 1]

chipping1 = np.array([1, 1, 1, -1, 1, -1, -1, -1])
chipping2 = np.array([1, -1, 1, 1, 1, -1, 1, 1])

assert is_orthogonal(chipping1, chipping2), "两个码片序列必须正交"

print("用户1", msg1)
print("用户2", msg2)

p1 = encode(msg1, chipping1)
p2 = encode(msg2, chipping2)

p = mix(p1, p2)
print("编码后传递的数据=", p)

res1 = decode(p, chipping1)
res2 = decode(p, chipping2)

print("用户1解码", res1)
print("用户2解码", msg2)
计算机网络性能
性能1
- 速率(数据率,data rate,数据传输率,比特率,bit rate)
- 每秒传输的信息量。
- 单位为
b/s,bps,kbs,Mbs,Gbs - 往往标定的是是 额定速率(理想状况下的速率)
- 带宽(bandwidth)
- 原本指最高频率与最低频率之差(单位 Hz)
- 计算机网络中,指的是所能传输的“最高数据率”(单位 bps)
- 延迟(时延,delay,latency)
- 原因:在某路由节点,分组到达速率超过容量,分组只好排队等待。如果缓存队列满了,分组还会被丢弃,叫做 丢包(loss)
- 分组交换网络的延迟为4个延迟的总和:
- 节点处理延迟(nodal processing delay)。节点处理导致的延迟
- 差错检测、确定输出链路
- 通常小于 1ms,通常讨论可忽略。做路由器内部优化需要重点关注的。
- 排队延迟(queueing delay)
- 等待输出链路可用
- 取决于路由器拥塞程度
- 其值是不确定的
- 传输延迟(transmission delay):发送信号所需时间。
- 取决于:1)分组大小(bits);2)链路带宽(bps)。
- 传输延迟=分组长度/链路带宽
- 传播延迟(propagation delay):信号在物理介质上的传播速度。
- 取决于:1)物理链路长度;2)信号本身的传播速度,例如铜缆中信号传播速度是 0.7倍光速
- 传播延迟=物理链路长度/信号本身的传播速度
- 传输延迟和传播延迟有严格区别。
- 类比:前者类似高速收费站的处理能力(一个卡车车队通过收费站时,第一辆发车到最后一辆离开收费站,所用的时间),后者类似卡车在高速公路上一个收费站到下一个收费站跑了多久。
- 两个节点之间的时间=节点处理延迟+排队延迟+传输延迟+传播延迟
排队延迟的计量
- 假设:
- R:链路带宽 (bps)
- L:分组长度(bits)
- a:平均分组到达速率
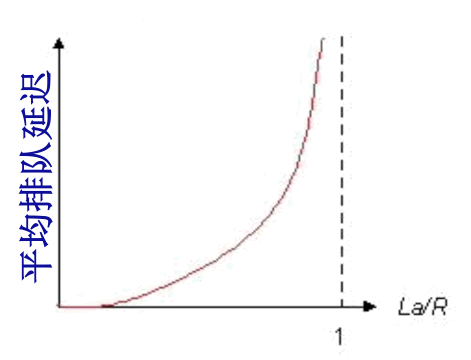
- 流量强度 (traffic intensity)=La/R
- 如果 La/R 接近零,平均排队延迟很小
- 如果 La/R 接近1,平均排队延迟很大
- 如果 La/R>1,超出服务能力,平均排队延迟无限大
- 他们的关系如下:
性能2
- 时延带宽积 = 传播延迟 x 带宽
- 相当于:第一个比特到达终点时,整个链路上有多少个比特
- 也可以称为 比特长度,就是某段链路有多少个比特
- 分组丢失(丢包)
- 丢包率 = 丢包数/总包数
- 吞吐量(吞吐率,Throughput):发送端与接收端之间的传送数据速率(bps)
- 取决于各链路中吞吐量最小的那个,最小的那个叫做 瓶颈链路(bottleneck link)
- 即时吞吐量(某时刻的速率)
- 平均吞吐量(一段时间的平均速率)
计算机网络体系结构
为什么需要计算机网络体系结构?
- 计算机网络十分复杂,涉及到许多组成:主机(hosts)、路由器(routers)、各种链路(links)、应用(applications)、协议(protocols)、硬件、软件、……
- 问题:如何描述它,至少让我们可以讨论它
计算机网络体系结构(简称网络体系结构,network architecture)
- 是从 功能上 描述计算机网络结构(而不是从硬件上描述)
- 是 分层结构
- 每层遵循某个/些 网络协议 完成本层功能
- 是计算机网络的各层及其协议的集合
- 是一个计算机网络的功能层次及其关系的 定义
- 是 抽象的
为什么采用分层结构?
- 结构清晰,有利于识别复杂系统的部件及其关系
- 也叫做分层的 参考模型(reference model)
- 模块化的分层易于系统更新、维护
- 任何一层服务实现的改变对于系统其它层都是透明的
- 例如,登机过程的改变并不影响航空系统的其它部分(层)
- 有利于标准化
- 分层是否有缺点?
- 分层太多:效率变低
- 某些特殊网络(如传感器),会做跨层设计,以提高效率
一些概念
- 服务:这一层向上一层提供什么能力
- 例如 TCP 向应用层提供:可靠的字节流、按序交付、流量控制
- 协议:同一层之间遵守什么规则
- 例如两台主机的 TCP 实现共同遵守:报文格式、序号规则、确认规则、重传规则、状态转换会在
- 接口:这一层如何调用下一层提供的服务
- 应用程序通过 Socket API 使用 TCP(
socket(), connect(), send(), recv())
- 应用程序通过 Socket API 使用 TCP(
OSI模型
- 开放系统互连 (OSI)参考模型是由国际标准化组织 (ISO) 于1984年提出的分层网络体系结构模型
- 目的是支持 异构网络系统 的互联互通
- 理论模型。理论成功,市场失败
- 功能上划分 7层,每层完成特定的网络功能
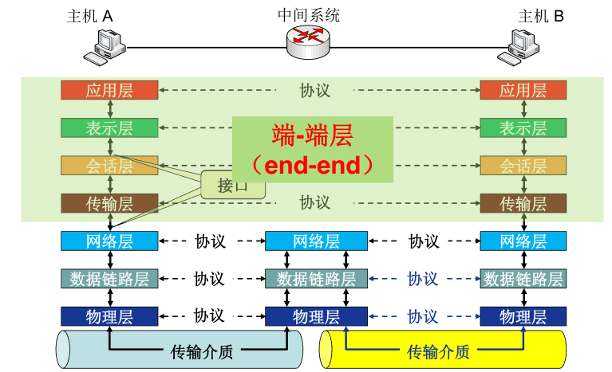
解释
- 上面的实线表示物理层面上数据的流动,虚线表示逻辑层面上的数据流动
- 前4个层次,不需要中间系统实现,叫做 end-end层
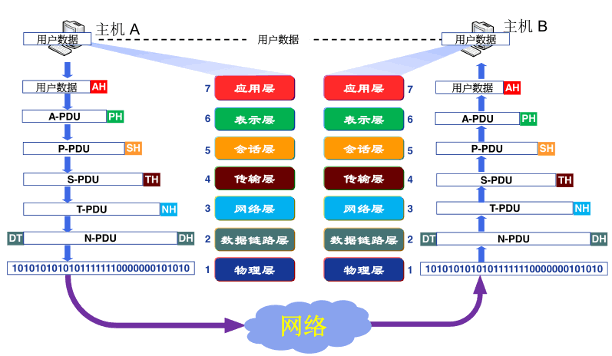
解释
- 每一步都增加 控制信息,包括
- 地址(Address):标识发送端/接收端
- 差错检测(Error-detecting code)
- 协议控制(Protocol control):协议中的附加信息,例如优先级、服务质量、安全控制等
1. 物理层:完成每个比特的传输
- 定义 接口特性,它包括4个方面:
- 机械特性:插口类型、位置
- 电气特性:电平、电压等
- 功能特性:多少个引脚,每个引脚的功能
- 规程特性:规定通信过程
- 定义 比特编码,如何表示0/1
- 什么样的调制技术/编码技术
- 定义 数据率,以多快速度发送
- 解决 比特同步,防止错过/提前接收一个比特,导致接收的比特错误
- 时钟同步
- 定义 传输模式
- 单工(Simplex),只能单向通信(传统电视)
- 半双工(half-duplex),交替双向,两边不能同时向对方发信息(对讲机)
- 全双工(full-duplex),双方可以同时向对方发送信息,一般用两个独立信道
2.数据链路层: 负责 结点-结点(node-node) (两个相邻节点)数据传输一 帧 数据
- 组帧(Framing):加头加尾,目的是接收方接收比特流后正确切分
- 物理寻址(Physical addressing):帧头中有发送端/接收端的 物理地址(物理地址标识)
- 流量控制(Flow control)
- 匹配发送端和接收端的速度。避免淹没接收端。
- 差错控制(Error control):检测并重传损坏或丢失帧,并避免重复帧
- 访问(接入)控制(Access control):任意给定时刻,哪个设备有物理介质的使用权
- 典型技术:Ethernet, Wi-Fi, PPP
3.网络层:穿越多个网络,从 源主机到目的主机 交付 数据分组(packet)
- 逻辑寻址(Logical addressing):全局唯一 的逻辑地址,确保数据分组被送达目的主机,如IP地址
- 路由(routing):路径选择
- 分组转发:每个节点收到一个分组,按照路由完成转发
- 核心协议:IPv4, IPv6, ICMP
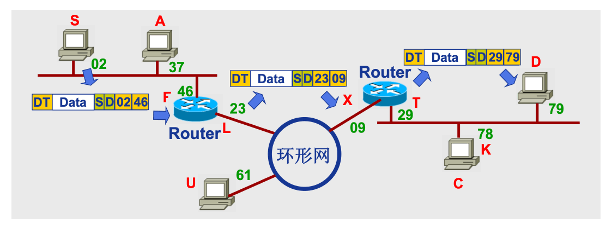
图片解释:
- 上面分组中的 S 和 D 是网络层添加的。它标记了源主机/目的主机的地址
- 数字是数据链路层添加的,它标记了每个节点时间的源/目的
- DT 也是数据链路层添加的,是帧分割标志
4.传输层:完成端到端的、完整报文的传输。数据转交给目标主机正确的进程。
- 分段和重组,发送端:把报文分割为段;接收端:把段重新组合成完整的报文
- SAP寻址
- 确保把完整报文提交给正确的 进程(例如端口号)
- 端到端的 连接控制,建立、维护、拆除。这里的连接是逻辑上的连接
- 端到端的 流量控制
- 差错控制
- 例如:TCP、UDP
5.会话层
- 对话控制(dialog controlling):建立、维护、拆除
- 同步(synchronization):在数据中插入n个“同步点”。一旦传输中断,可以从上一个“同步点”继续传输。
- 功能最少的一层。实际应用中,这一层不是单独存在的,合并到应用层。
6.表示层:处理两个系统见交换信息的 语法和语义(syntax and semantics)问题
- 数据表示转化,
- 字符编码: UFT-8
- 大端数/小端数
- 序列化:JSON、Protocol Buffers
- 压缩/解压缩:gzip
- 图片格式:JPEG、PNG
- 加密/解密
- 实际应用中。这一层也不是独立存在的,合并到应用层。
7.应用层:不同的应用对应不同的应用层协议,例如:HTTP、FTP、SMTP
- 支持用户使用用户代理(如浏览器、邮箱软件)或网络接口使用网络
其它模型
TCP/IP模型
- 共4层
- 所有应用都架构在IP上
- IP之上是 TCP 和 UDP
- 网络接口层没有定义具体协议,只要求其能够封装 IP分组,使其能在结点间传输
TCP/IP模型与 OSI 对应关系
- 应用层 → 应用层 + 表示层 + 会话层
- 传输层 → 传输层
- 网际层 → 网络层
- 网络接口层 → 数据链路层 + 物理层
5层参考模型:把 TCP/IP 的 “网络接口层”分为两层:“数据链路层”、“物理层”
- 应用层 : 支持各种网络应用
- FTP, SMTP, HTTP
- 传输层 : 进程-进程的数据传输
- TCP, UDP
- 网络层 : 源主机到目的主机的数据分组路由与转发
- IP协议、路由协议等
- 链路层 : 相邻网络元素(主机、交换机、路由器等)的数据传输
- 以太网(Ethernet)、802.11 (WiFi)、PPP
- 物理层 : 比特传输
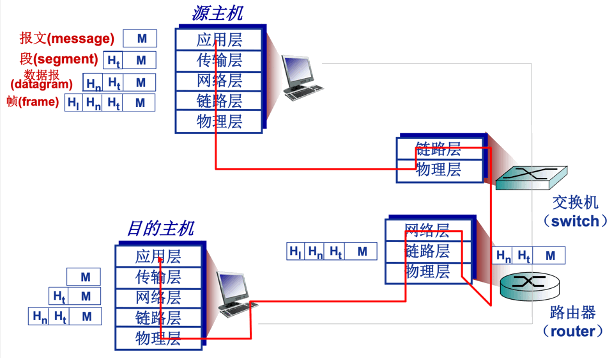
3个模型之间的关系:OSI 是理论模型,TCP/IP 模型是实际在用的,5层模型是介于 OSI 和 TCP/IP 模型的为教学方便使用的模型。
应用层
网络应用的体系结构
- C/S(客户机/服务器,Client-Server)
- 服务器:1)7x24小时提供服务、2)永久性访问地址/域名、3)利用大量服务器实现可扩展性
- 客户机:1)与服务器通信,使用服务器的服务,2)间歇性接入网络,3)可能使用动态IP,4)不与其它客户机直接通信
- 典型例子是 Web:服务器运行Web服务,客户机上运行游览器
- P2P(点对点结构,Peer-to-Peer)
- 没有永远在线的服务器
- 任意端/节点之间可以直接通讯
- 节点间歇性接入网络
- 节点可能改变IP地址
- 典型例子:BT下载
- 优点:高度可伸缩。缺点:难以管理
- 混合结构(Hybrid)。 C/S和P2P的混合
- 典型例子:Napster,文件传输用P2P,文件搜索用C/S
进程通信
- 同一主机上运行的进程之间的通信。进程间通信,操作系统提供了各种方式。
- 不同主机上运行的进程之间:消息交换(报文交换)
- 客户机进程:发起通信的进程
- 服务器进程:等待通信请求的进程
- P2P也有以上进程
socket:一种编程接口(API),为网络通信提供一种抽象的数据通道
- 操作系统提供
- 可用于同一个主机、不同主机之间的通信
不同主机之间的进程间通信需要 标识符:IP地址+端口号
- HTTP Server:80
- Mail Server:25
应用层协议
- 公开协议
- 由 RFC(Request For Comments)定义
- 允许互操作
- 例如:HTTP,SMTP,…
- 私有协议
- P2P 文件共享应用
- 可以自己设计协议
应用层协议 的内容
- 消息的类型(type)
- 请求消息
- 响应消息
- 消息的语法(syntax)/格式
- 消息中有哪些字段(field)?
- 每个字段如何描述
- 字段的语义(semantics)
- 字段中信息的含义
- 规则(rules)
- 进程何时发送/响应消息
- 进程如何发送/响应消息
网络应用的需求与传输层服务
网络应用的服务需求
- 数据丢失(data loss)/可靠性(reliability)
- 某些网络应用能够容忍一定的数据丢失:网络电话、在线视频
- 某些网络应用要求100%可靠的数据传输:文件传输,telnet、网上银行
- 时间(timing)/延迟(delay)
- 有些应用只有在延迟足够低时才“有效”
- 网络电话/网络游戏
- 带宽(bandwidth)
- 某些应用只有在带宽达到最低要求时才“有效”:在线视频
- 某些应用能够适应任何带宽:email、文件下载
- 其它需求
- 安全等
Internet传输层服务模型
- TCP服务
- 面向连接: 客户机/服务器进程间
- 需要建立连接
- 双工
- 可靠的传输
- 流量控制: 发送方不会发送速度过快,超过接收方的处理能力
- 拥塞控制: 当网络负载过重时能够限制发送方的发送速度
- 不提供:
- 时间/延迟保障
- 最小带宽保障
- 面向连接: 客户机/服务器进程间
- UDP服务
- 无连接
- 不可靠的数据传输,不提供:
- 可靠性保障
- 流量控制
- 拥塞控制
- 延迟保障
- 带宽保障
- 例子:网络电话、网络视频
Web 应用
- Word Wide Web
- 网页(Web page)包含多个对象(Objects)
- HTML文件、JPEG图片、动态脚本等
- 对象的寻址
- URL(Uniform Recourse Locator):统一资源定位器 RFC1738
Scheme://host:port/path- scheme:协议
- HTTP协议(超文本传输协议,Hyper Text Transfer Protocol)
- C/S结构
- S端一般用 Apache Web
- C端可以是各种浏览器
- HTTP协议版本:1.0:RFC1945,1.1:RFC2068
- C/S结构
- HTTP 依赖 TCP
- 服务器在80端口等待客户请求
- 浏览器发起到服务器的TCP连接(创建 Socket)
- 服务器接受来自浏览器的TCP连接
- 浏览器与Web服务器交换HTTP消息
- 关闭TCP连接
- 无状态(stateless):服务器不维护任何有关客户端过去发送的请求
HTTP连接
- 非持久性连接(NonpersistentHTTP)
- 每个TCP连接最多允许传输一个对象
- HTTP 1.0版本
- 持久性连接(Persistent HTTP)
- 每个TCP连接允许传输多个对象
- HTTP 1.1版本默认

缺点:
- 响应时间
- 定义 RTT(Round Trip Time):客户端发送极小数据,然后服务器返回数据所用的时间
- 每个对象的响应时间 = 2RTT+文件传输时间
- 如果有10个jpeg,还额外需要 20RTT + 文件传输时间
- TCP 连接过多
- 服务器需要为每个 TCP 连接开销资源
- 浏览器为了提高性能会并行打开多个 TCP 连接,导致服务器性能消耗很大
- 解决:持久性连接
持久性连接
- 发送响应后,服务器保持 TCP 连接的打开
- 后续的 HTTP 消息继续使用这个连接发送
- 每个对象时间消耗只有 1RTT+件传输时间
- 无pipelining:串行,每个对象1个 RTT
- 带pipeline:并行,所有耗时1RTT
HTTP消息
HTTP消息分为两种:
- request
- response
方法类型
- HTTP/1.0
- GET:获取资源,例如获取文章,查询数据
- POST:提交数据
- HEAD:不要把请求的对象放入响应消息中。往往用来做测试。
- HTTP/1.1
- GET、POST、HEAD
- PUT:提交并替换目标资源
- DELETE:删除资源
- HTTP/2
- 不是纯文本,而是二进制。机器处理效率高。
- 多路复用,一个 TCP 里可以同时跑多个 stream(网络文件,如 index.html, style.css)
- 头压缩
- 可明文、可加密,一般配合 HTTPS(HTTP over TLS)
参考 ➡️ 状态响应码
Cookie技术
- HTTP 是无状态的
- 但很多网站需要辨别用户身份、进行session跟踪
- Cookie 是储存在用户本地终端上的数据(通常经过加密)。
- RFC6265
Cookie的组件
- HTTP响应消息的cookie头部行
- HTTP请求消息的cookie头部行
- 保存在客户端主机上的cookie文件,由浏览器管理
- Web服务器端的后台数据库
Cookie 的用途
- 身份认证
- 购物车
- 推荐
Cookie 的缺点:隐私问题
Web缓存
优点:
- 减少响应时间
- 减少组织的流量
如何做?
- 用户不访问原始服务器,而是向缓存/代理服务器发送所有HTTP请求
- 如果请求对象在缓存服务器中,则直接返回给用户
- 否则,缓存服务器向原始服务器发送 HTTP 请求,然后返回给用户。(同时缓存服务器保存对象)
- 一般 ISP 架设
一致性问题:缓存服务器如何判断原始服务器的内容是不是变了?
- 缓存服务器发送
If-modified-since:<data> - 服务器:如果缓存的版本是最新的,则response 是不包含对象的
HTTP/1.0 304 Not Modified,这就极大节省了流量/时间。
Email应用
Email应用的构成组件
- 邮件客户端(user agent)
- 读、写Email消息
- 与服务器交互,收、发Email消息
- Outlook, Foxmail, Thunderbird
- Web客户端
- 邮件服务器(Mail Server)
- 邮箱:存储发给该用户的Email
- 消息队列(message queue):存储等待发送的Email
- SMTP协议(Simple Mail Transfer Protocol)
- 邮件服务器之间传递消息所使用的协议
- 客户端:发送消息的服务器
- 服务器:接收消息的服务器
SMTP协议: RFC 2821
- 使用TCP进行email消息的可靠传输
- 端口 25
- 传输过程的三个阶段
- 握手
- 消息的传输
- 关闭
- 命令/响应交互模式
- 命令(command): ASCII文本
- 响应(response): 状态代码和语句
- Email消息只能包含7位ASCII码
- 利用 回车+换行+句号
CRLF.CRLF确定消息的结束
- 利用 回车+换行+句号
一些协议
| 协议/标准 | 主要作用 | 说明 |
|---|---|---|
| SMTP (Simple Mail Transfer Protocol) | 客户端→服务器,服务器→服务器 发送邮件 |
RFC 2821 (被 RFC 5322 取代) |
| POP(Post Office Protocol) | 服务器→客户端 下载邮件,然后在服务器上删除 |
RFC 1939 最成熟、最普及的是 POP3 IMAP 是其替代者 |
| IMAP(Internet Mail Access Protocol) | 服务器↔客户端 在服务器上管理和同步邮件 更多功能、更加复杂、能够操纵服务器上存储的消息 |
RFC 1730 |
| HTTP | 网页客户端 | |
| RFC 822 | 定义邮件基本格式(头+体) | 被 RFC 5322 取代 |
| RFC 2045 | 定义 MIME 类型和编码 | 活跃 |
| RFC 2056 | 定义 MIME 安全扩展 | 活跃但部分内容已替代 |
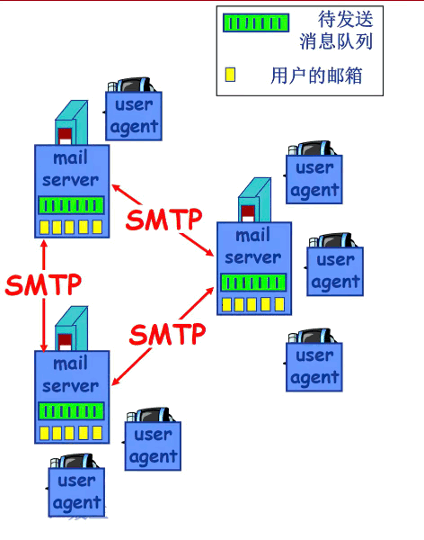
SMTP 交互示例
S: 220 hamburger.edu
C: HELO crepes.fr
S: 250 Hello crepes.fr, pleased to meet you
C: MAIL FROM: <alice@crepes.fr>
S: 250 alice@crepes.fr... Sender ok
C: RCPT TO: <bob@hamburger.edu>
S: 250 bob@hamburger.edu ... Recipient ok
C: DATA
S: 354 Enter mail, end with "." on a line by itself
C: Do you like ketchup?
C: How about pickles?
C: .
S: 250 Message accepted for delivery
C: QUIT
S: 221 hamburger.edu closing connection
安装telnet
sudo apt update
sudo apt install telnet

# 现代都强制用 SSL 加密传输
sudo apt install openssl
用 telnet 发送邮件
telnet smtp.qq.com 25
HELO qq.com
SMTP 与 HTTP 对比
- HTTP:客户端主动拉取(pull)数据。SMTP:客户端主动推送(push)数据到服务器。
- 都是 request/response 交互模式
- 命令和状态码都是 ASCII 码
- HTTP:每个对象封装在独立的响应消息中
- SMTP:多个对象由多个部分构成的消息中发送
SMTP 和 POP3
- RFC822:邮件基本格式
- header,包含 To、From、Subject
- body,消息本身(只能是 ASCII 字符)
- MIME:多媒体邮件扩展 RFC2045, 2056
- 在 header 增加额外的行以声明MIME的内容类型
邮件访问协议:从服务器获取邮件
- POP:认证/授权(客户端->服务器)和下载
- IMAP
- HTTP:163, QQ Mail等。
POP协议
- 认证过程
- 客户端命令
User:声明用户名Pass: 声明密码
- 服务器响应
- +OK
- -ERR
- 客户端命令
- 事务阶段
- List:列出消息数量
- Retr:用编号获取消息
- Dele: 删除消息
- Quit
POP协议
- “下载并删除”模式(默认),下载后自动删除服务器上的副本
- “下载并保持”模式
- POP3是无状态的
IMAP协议
- 所有消息统一保存在一个地方:服务器
- 允许用户利用文件夹组织消息
- IMAP支持跨会话(Session)的用户状态:
- 文件夹的名字
- 文件夹与消息ID之间的映射等
DNS应用
问题:把域名翻译到IP地址
DNS
- 多层命名服务器构成的分布式数据库
- 应用层协议:完成名字的解析
- 提供Internet核心功能
- 用应用层协议实现
- 网络边界复杂
DNS服务
- 域名向IP地址的翻译
- 主机别名
- 邮件服务器别名
- 负载均衡:Web 服务器轮流排在前面
问题:为什么不使用集中式的DNS?
- 单点失败问题。集中式一旦某台服务器坏了,整个互联网就坏了。
- 流量问题。几十亿台主机都在单台服务器查询。
- 距离问题。
- 维护性问题
DNS采用 分布式、层次式数据库
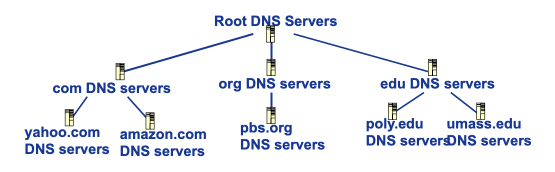
客户端想要查询 www.guofei.site 的IP
- 客户端查询根服务器,找到 site 域名解析服务器
- 客户端查询 site 域名解析服务器,找到 guofei.site 域名解析服务器
- 客户端查询 guofei.site 域名解析服务器,获得 www.guofei.site 的IP地址
DNS的层级
- DNS 根域名服务器
- 本地域名解析服务无法解析域名时,访问根域名服务器
- 全球共13个
- 顶级域名服务器(TLD,top-level domain)
- 负责 com、org、net、edu、cn、uk、fr 等顶级域名
- 权威(Authoritative)域名服务器
- 组织(例如大学)维护
- 服务提供商维护
- Local DNS server(不属于层级体系)
- ISP 提供
- 默认的域名解析服务器
- 主机进行 DNS 查询时,查询先发送到本地域名解析服务器
- 本地域名解析服务器作为代理(proxy),将查询转发给(层级式)域名解析服务器系统
DNS查询有两种:迭代查询 和 递归查询
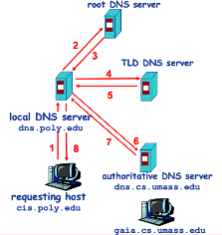
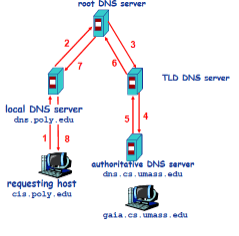
缓存
- 一段时间后,缓存失效
- Local DNS server 会缓存顶级域名服务器的映射
- 因此根域名服务器不经常被访问
DNS的格式
- DNS的记录是 资源记录(RR,resource records),是一个四元组,(name,value,type,ttl)
Type=A,Name:主机域名,Value:IP地址Type=NS,Name:域(edu.cn),Value:域权威域名解析服务器的主机域名。功能:根据域给出对应能解析的服务器。Type=CNAME,Name:别名,Value:真实域名。实现别名服务。Type=MX,Value是Name对应的邮件服务器
DNS协议:
- 查询(query)和 回复(reply消息)
- 两则格式相同
- 消息头部

P2P应用
P2P 是什么?(Peer-to-peer)
- 没有服务器
- 任意端系统之间直接通信
- 节点阶段性接入Internet
- 节点可能更换IP地址
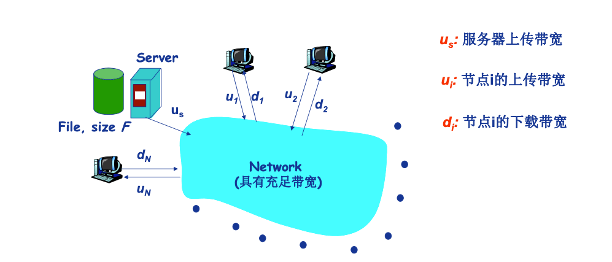
C/S 和 P2P 分发总时间
- C/S架构下,
- 服务器需要发送N个副本,用时 $NF/u_s$
- 客户机i下载需要 $f/\min(d_i)$
- 总耗时:$\max { NF/u_s,f/\min(d_i) }$
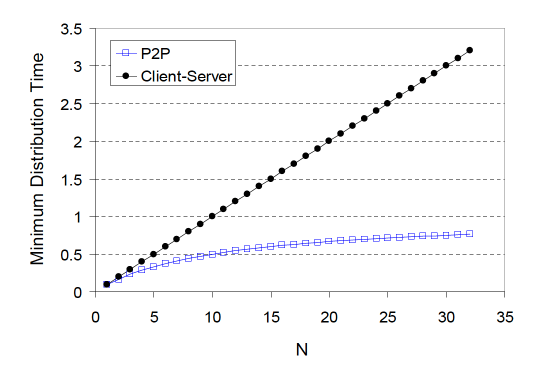
- N较大时线性增长
- P2P架构下,
- 服务器需要发送1个副本,用时 $F/u_s$
- 客户机i需要 $F/d_i$ 下载时间
- 整个网络的总上传速度为 $u_s+\sum u_i$
- 总耗时 $\max { F/u_s, F/\min(d_i), NF/(u_s+\sum u_i) }$
- N足够大时,耗时增长很慢
BitTorrent
- 文件划分为 256KB 的chunk
- 节点加入torrent
- 下载的同时,节点需要向其他节点上传 chunk
- 节点可能加入或离开,所以是动态的
- 一旦节点获得完整的文件,它可能离开(自私)或留下(无私)
- 获取chunk
- 给定任一时刻,不同的节点持有文件的不同chunk集合
- 节点(Alice)定期查询每个邻居所持有的chunk列表
- 节点发送请求,请求获取缺失的chunk
- 稀缺优先。例如,某个chunk有3个提供,另一个chuck有100个节点提供,则会优先获取前者,防止3个节点都下线。
- 发送chunk: tit-for-tat(以牙还牙)
- Alice向4个邻居发送chunk:正在向其发送Chunk,速率最快的4个
- 每10秒重新评估top 4
- 每30秒随机选择一个其他节点,向其发送chunk
- 新选择节点可能加入top 4
- “optimistically unchoke”
- 因此,最终效果是,上传的越快,下载的也快
- Alice向4个邻居发送chunk:正在向其发送Chunk,速率最快的4个
P2P的索引技术
索引 是信息到节点位置(IP+端口号)的映射
- 文件共享(电驴)
- 索引动态跟踪节点所共享的文件
- 节点告诉索引它拥有哪些文件
- 节点询问索引,从而获知能够得到哪些文件
- 即时消息(QQ)
- 索引负责将用户名映射到位置
- 当用户开启IM应用时,需要通知索引它的位置
- 节点检索索引,确定用户的IP地址
方案1:集中式索引(Napster最早采用这种设计)
- 节点加入时,通知中央服务器:IP地址、内容
- Alice 查找 “xx.avi”
- Alice 从 Bob 处请求文件
特点:内容和文件传输是分布式的,但是内容定位是高度集中式的
- 单点失效问题。中央服务器崩了,整个服务就会失败
- 性能瓶颈。节点的动态更新、查找都向中央服务器报告,
- 版权问题。Napster 被诉讼关闭正是由于集中式架构让它暴露于版权监管之下。
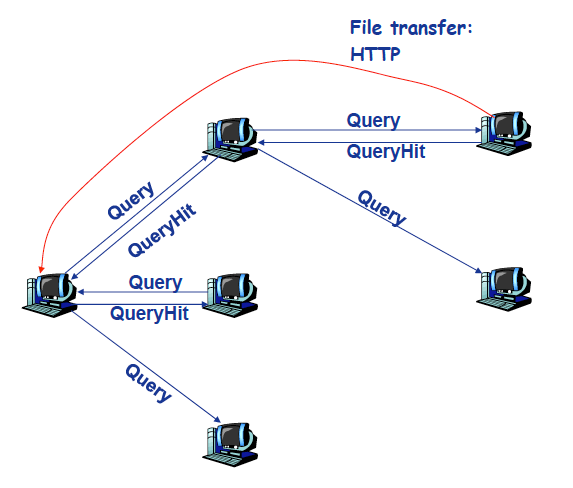
方案2:洪泛式查询: Query flooding
- 完全分布式架构
- Gnutella采用这种架构
- 每个节点对它共享的文件进行索引,且只对它共享的文件进行索引
- 覆盖网络(overlay network): Graph
- 节点X与Y之间如果有TCP连接,那么构成一个边
- 所有的活动节点和边构成覆盖网络
- 边:虚拟链路
- 节点一般邻居数少于10个
查询方法:
- A节点向邻居发送查询消息
- 每个邻居转发查询消息
- 如果查询命中,则利用反向路径发回查询节点
缺点:
- 消息泛滥,给网络带来很大的负担
- 节点刚加入时,有很多需要处理的消息
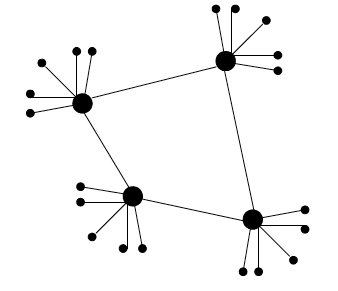
方案3:层次式覆盖网络。集中式索引和洪泛查询的结合
- 节点分为两种:普通节点、超级节点
- 节点和超级节点间维持TCP连接
- 某些超级节点之间维持TCP连接
- 超级节点负责跟踪子节点的内容
- 一旦完成查询,仍然是点对点的传输
- 例子:Skype
Socket编程

应用编程接口API(Application Programming Interface)
- 传输层、网络层、数据链路层、物理层是由操作系统提供的
- Socket API 是事实上的工业标准,绝大多数操作系统都支持
- 是Internet网络应用最常用的 API
- 通信模型:客户/服务器(C/S)
- Socket 提供了应用进程间通信的抽象机制
Socket 定位
- 对外,IP+端口号
- 操作系统/进程,使用 socket descriptor(一个小整数)
Socket 抽象
- 类似文件的抽象
- 进程创建 Socket 时候,操作系统分配一个数据结构存储相关信息
struct sockaddr_in
{
u_char sin_len; /*地址长度 */
u_char sin_family; /*地址族(TCP/IP:AF_INET;非TCP/IP则是其他值) */
u_short sin_port; /*端口号 */
struct in_addr sin_addr; /*IP地址 */
char sin_zero[8]; /*未用(置0) */
}
Socket API(WinSock)
- 初始化
WSAStartup- 参数1:WinSock版本
- 参数2:指向WSDATA的指针
- 释放
WSACleanup - 创建
sd = socket(protofamily, type, proto);- protofamily:协议族。如果是 TCP/IP,则
protofamily = AF_INET - type:类型
SOCK_STREAMTCP协议SOCK_DGRAMUDP 协议SOCK_RAW直接向网络层(需要root权限)
- proto:协议号,默认0
- 创建流式 Socket
struct protoent *p; p = getprotobyname("tcp"); SOCKET sd = socket(PF_INET,SOCK_STREAM,p->p_proto); - TCP:可靠、有连接、字节流传输、点对点
- UDP:不可靠、无连接(不用连接直接发送)、数据报传输
- protofamily:协议族。如果是 TCP/IP,则
- 关闭
closesocket- 如果多个进程共享一个 socket,引用计数减1,减到0才关闭
- 一个进程的多线程共享一个 socket,引用计数算成1
- socket 绑定本地端点地址(IP+端口号)
bind(sd,localaddr,addrlen)- 客户端不用调用,会在
connect()时自动分配端口 - 服务器端,可以用地址通配符
INADDR_ANY,来指定任意IP
- 客户端不用调用,会在
listen(sd,queuesize)置 socket 为监听状态- 仅用于服务端,仅用于 TCP
- queuesize,请求队列大小
connect(sd,saddr,saddrlen)- 仅用于客户端
- saddr:目的主机的端口
- 可用于 TCP/UDP
accept(sd,caddr,caddrlen)从监听队列中取出一个- 仅用于 TCP
- 仅用于服务器
- 会创建一个新的 Socket,接下来用新的 socket 与该客户机通信。(目的是实现并发为多个客户机服务)
- 发送数据
send(sd,*buf,len,flags);,sendto(sd,*buf,len,flags,destaddr,addrlen)send用于 TCP,或者调用了 connect 的 UDPsendto用于 UDP 服务器端 socket,或者 未调用 connect 的客户端 socket
- 接收数据
recv(sd,*buffer,len,flags);和recvfrom(sd,*buf,len,flags,senderaddr,saddrlen);recv从 TCP 接收数据,或者 调用了 connect 的 UDP 客户端recvfrom从 UDP 服务器端接收,或者 未调用 connect 的 UDP 客户端接收
setsocketopt和getsocketopt设置和获取 socket 参数
字节格式转化
- “表示层”处理字节顺序(例如大端、小端),但 TCP/IP 协议也规定了标准。
- 因此在使用 socket 的时候可以把本地字节顺序转换为网络字节顺序。socket 提供了一系列的转换函数。

Socket编程-客户端软件设计
- 解析服务器IP地址
- 客户端可能使用 域名 或 IP地址 标识服务器
inet_addr()IP地址的进制转换gethostbyname()域名到IP的转换
- 解析端口号
- 客户端可能使用 服务名 标识服务器端口号
- 例如 HTTP 对应 80
- 函数
getservbyname()从服务名获取端口号
- 解析协议号
- 例如 TCP 对应 6
getprotobyname()从协议名获取端口号
TCP 客户端软件流程
- 确定服务器IP地址与端口号
- 创建 socket
- 分配本地端点地址(IP地址+端口号)。
- 自动完成
- IP通常是内网(192.168.x.x)或者公网IP
- 端口号是操作系统临时分配的,通常在 49152~65535 之间
- 连接服务器(socket)
- 遵循应用层协议进行通信
- 关闭/释放连接
UDP 客户端软件流程
- 确定服务器IP地址与端口号
- 创建 socket
- 分配本地端点地址(IP地址+端口号)
- 指定服务器端点地址,构造UDP数据报
- 遵循应用层协议进行通信
- 关闭/释放 socket
Socket编程-服务器软件设计
| 类型 | 常见传输协议 | 基本特点 |
|---|---|---|
| 循环无连接服务器 (Iterative connectionless) | UDP | 逐个处理数据报 |
| 循环面向连接服务器 (Iterative connection-oriented) | TCP | 一次完整服务一个连接 |
| 并发无连接服务器 (Concurrent connectionless) | UDP | 同时处理多个数据报 |
| 并发面向连接服务器 (Concurrent connection-oriented) | TCP | 同时处理多个连接 |
循环无连接
- 创建 socket
- 绑定端点地址(INADDR_ANY+端口号)
- 反复接收来自客户端的请求
recvfrom() - 遵循应用层协议,构造响应报文,发送给客户 (
sendto())。回到3,处理下一个客户请求。
不使用 listen() 和 accept()
循环面向连接
- 创建(主)socket,并绑定端口(
bind()); - 设置(主)socket 为被动监听模式(
listen()),准备用于服务器; - 调用
accept()函数接收下一个连接请求(通过主socket),创建新socket用于与该客户建立连接;- 新 socket 端口号与主 socket 一样。
- 遵循应用层协议,反复接收客户请求,构造并发送响应(通过新socket);
- 完成为特定客户服务后,关闭与该客户之间的连接,返回步骤3.
并发无连接
- 主线程:
- 创建socket,并绑定熟知端口号;
- 反复调用
recvfrom()函数,接收下一个客户请求,并创建新线程处理该客户响应;
- 子线程
- 接收一个特定请求;
- 依据应用层协议构造响应报文,并调用
sendto()发送; - 退出(一个子线程处理一个请求后即终止)。
并发面向连接
- 主线程
- 创建(主)socket,并绑定熟知端口号;
- 设置(主)socket为被动监听模式,准备用于服务器;
- 反复调用
accept()函数接收下一个连接请求(通过主socket),并创建一个新的子线程处理该客户响应;
- 子线程
- 接收一个客户的服务请求(通过新创建的socket);
- 遵循应用层协议与特定客户进行交互;
- 关闭/释放连接并退出(线程终止).
常见端口号和错误码
其中常见的 响应状态码:
200 OK301 Moved Permanently400 Bad Request403 Forbidden: 无权限访问404 Not Found500 Internal Server Error: 服务器内部错误505 HTTP Version Not Supported
端口号约定:
| 范围 | 名称 | 含义 |
|---|---|---|
| 0–1023 | Well-known ports | 系统/标准服务常用端口 |
| 1024–49151 | Registered ports | 应用程序注册端口,例如 MongoDB、Redis 做安全排查时,需要排查常见的数据库端口(下面不列出来) |
| 49152–65535 | Dynamic / Ephemeral ports | 客户端临时端口,或程序随机使用 |
常用端口速查:
| 端口 | 协议 | 常见用途 |
|---|---|---|
| 20 | TCP | FTP 数据连接,主动模式 |
| 21 | TCP | FTP 控制连接 |
| 22 | TCP | SSH、SFTP、SCP |
| 23 | TCP | Telnet,明文远程登录,基本应禁用 |
| 25 | TCP | SMTP 邮件发送,服务器间投递 |
| 53 | TCP/UDP | DNS 查询;UDP常见,TCP用于大响应/区域传送等 |
| 67 | UDP | DHCP Server |
| 68 | UDP | DHCP Client |
| 69 | UDP | TFTP,简单文件传输 |
| 80 | TCP | HTTP |
| 110 | TCP | POP3 收邮件 |
| 123 | UDP | NTP 时间同步 |
| 135 | TCP/UDP | Windows RPC Endpoint Mapper |
| 137 | UDP | NetBIOS Name Service |
| 138 | UDP | NetBIOS Datagram Service |
| 139 | TCP | 老式 Windows 文件共享 |
| 143 | TCP | IMAP 收邮件 |
| 161 | UDP | SNMP 查询 |
| 162 | UDP | SNMP Trap |
| 389 | TCP/UDP | LDAP |
| 443 | TCP | HTTPS |
| 445 | TCP | SMB/CIFS,Windows 文件共享 |
| 465 | TCP | SMTPS,SMTP over SSL/TLS |
| 500 | UDP | IKE,IPsec VPN |
| 514 | UDP/TCP | Syslog |
| 587 | TCP | SMTP Submission,客户端提交邮件 |
| 631 | TCP/UDP | IPP,网络打印 |
| 636 | TCP | LDAPS + |
| 993 | TCP | IMAPS |
| 995 | TCP | POP3S |
| 1883 | TCP | MQTT 明文(物联网协议),安全的做法是用 8883 |
| 2049 | TCP/UDP | NFS(网络文件系统) |
| 3389 | TCP/UDP | RDP,Windows 远程桌面 |
| 5900 | TCP | VNC (远程桌面协议) |
| 8080 | TCP | HTTP 备用端口、代理、Web 管理后台 |
| 8443 | TCP | HTTPS 备用端口、Web 管理后台 |
传输层
传输层协议
- UDP:无连接传输服务
- 不可靠的交付服务
- 基于“尽力而为(Best-effort)”的网络层,没有做(可靠性方面的)扩展
- TCP:面向连接的传输服务
- 可靠、按序的交付
- 拥塞控制
- 流量控制
- 连接建立
多路复用和多路分用
- 接收端 多路分用。传输层依据头部信息将收到的 Segment 交给正确的 Socket(即不同的进程)
- 发送端 多路复用。从多个Socket接收数据,为每块数据封装上头部信息,生成 Segment,交给网络层

| 字段名 | 作用 |
|---|---|
| 源端口号 | 哪个应用发来的 |
| 目的端口号 | 发给哪个应用(比如 80) |
| 序号 (Sequence Number) | 该段数据在整个字节流中的起始字节号 |
| 确认号 (Acknowledgement Number) | 用于确认收到对方的序号 |
| 数据偏移(Header Length) | 表示 header 有多长 |
| 标志位(URG, ACK, PSH, RST, SYN, FIN) | 连接控制和数据传输标识 |
| 窗口大小 | 告诉对方我还能接收多少数据 |
| 校验和 | 检查 segment 是否损坏 |
| 紧急指针 | 与 URG 位配合使用 |
| 可选项(Options) | 比如最大报文段 MSS,窗口扩大因子等 |
复用/分用时,靠二元组/四元组来判断 segment 对应的 socket
- UDP socket 用二元组(目的 IP、目的端口)
- TCP socket 用四元组(客户端 IP、客户端端口、服务器 IP、服务器端口)
UDP
UDP (User Datagram Protocol) RFC768
- UDP 基于 IP 协议,(只)做这些:
- 复用/分用
- 简单的错误校验
- 虽然链路层也有 ECC,但是 1)做为一个抽象层,下一层可能使用不同的协议、物理链路,未必都有 ECC;2)即使链路器有 ECC,存储转发时也可能出错。
- “Best effort”服务,UDP段可能
- 丢失
- 非按序到达
- 无连接
- UDP发送方和接收方之间不需要握手
- 每个UDP段的处理独立于其他段
- 优点
- 无须建立连接:延迟小
- 无须维护连接状态:实现简单
- 头部开销少
- 没有拥塞机制:可以更好地控制发送时间和速率
- 常用于
- 流媒体:容忍丢失,但速率敏感
- DNS
- SNMP
- 在 UDP 上实现可靠数据传输?
- 在应用层增加可靠性机制
- 应用特定的错误恢复机制

checksum 算法(见于 擦除码-checksum)
Rdt
Rdt(可靠数据传输协议,reliable data transfer protocol) 是一个教学模型。对应现实的 TCP
- 逐步推导“如何在不可靠信道上实现可靠传输”
- 底层信道不可靠:比特错误、丢包、重复和乱序
- 什么是可靠?不错、不丢、不乱

Rdt 的设计思路
- 渐进设计
- 只考虑单向传输(因为双向传输在单向传输上x2即可)
- 但是控制信息是双向流动的
- 利用 有限状态机(FSM,Finite State Machine)刻画传输协议

Rdt 1.0:可靠信道上的可靠数据传输
- 假设底层可靠:不错、不丢、不乱
- 因此,发送方和接收方的 FSM 独立

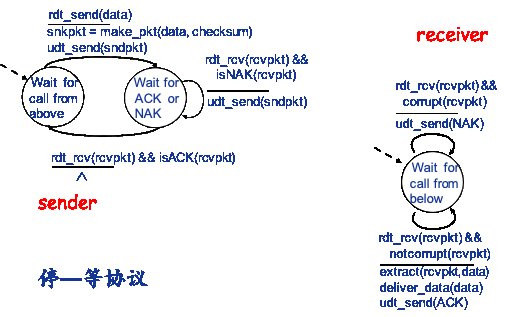
Rdt2.0:只可能产生位错误的信道
- 假设:不丢、不乱,但比特可能被破坏
- 加入机制:
- 差错检测(Error Detection):用 checksum 来做
- ACK (肯定确认, Acknowledgements): 接收方显式地告知发送方分组已正确接收
- NAK (Negative Acknowledgement,否定确认):接收方显式地告知发送方分组发生错误
- 重传(Retransmission)
- 如何运作
- NAK:接收方显式地告知发送方分组有错误
- 发送方收到NAK后,重传 分组
- 基于这种重传机制的rdt协议称为ARQ(Automatic Repeat reQuest)协议
Rdt2.0的缺陷
- 如果 ACK/NAK 损坏/丢失,怎么办?
- ❌ 方案1: 为 ACK/NAK 做 checksum
- ❌ 方案2: 当收到破坏的 ACK/NAK,添加额外的控制消息
- ✅ 方案3: 当收到破坏的 ACK/NAK,发送方重传
- 但可能产生 重复分组
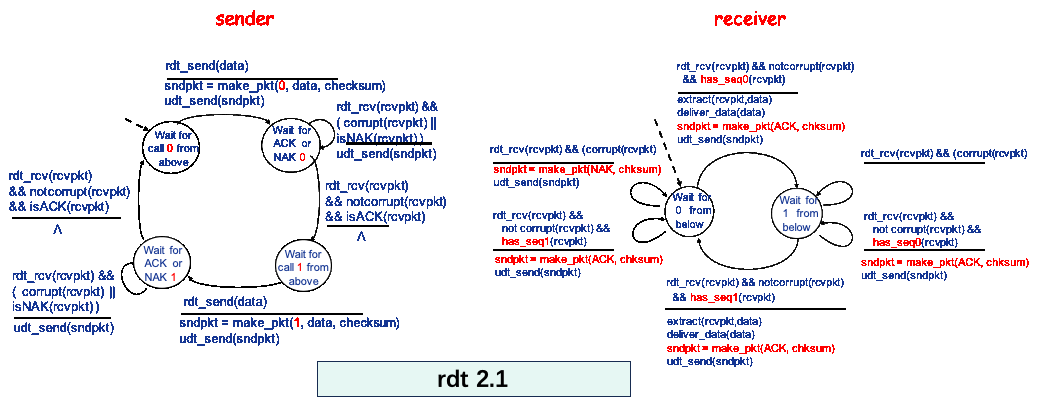
Rdt2.1:应对 ACK/NAK 损坏的情况。加入机制:
- 序号(Sequence Number)
0, 1, 0, 1, 0, ...- 只用 0/1 就够了
- 因为:某个数据块为 0,发送方重传仍然是 0. 接受方就知道这是重复的,它只需重新返回 ACK,并且不把它交付到应用层即可
- 对 ACK/NAK 的 checksum
- 重传:如果收到的 ACK/NAK 出错,也重传(收到 NAK 也重传,这一点是继承 Rdt2.0 的规定)。
Rdt2.1的缺陷:真的需要 NAK 吗?只使用 ACK 如何实现?
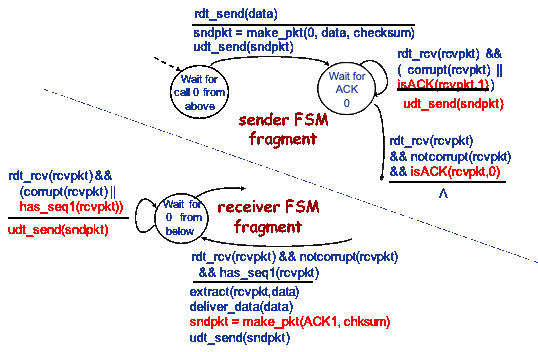
Rdt2.2
- 接收方只发送 ACK,在ACK 中写明 “我这次收到的是哪个序号”,
- 假如接受方期待接受
1,并且接受到了正确的1,则返回ACK(1) - 否则返回
ACK(0)
- 假如接受方期待接受
- 发送方期待收到
ACK(1),但却收到了ACK(0),就知道这次分组没有正确到达,重传当前分组
Rdt3.0 前面只假设可能产生位错误,如果分组也可能丢失呢?
- 假设:可能发生比特错误、丢失数据分组、丢失 ACK
- 引入机制:
- 定时器(Timer)
- 做法:
- 发送方等待 合理 的时间
- 如果没收到ACK,重传(这种情况可能是发送包丢了,也可能是返回的 ACK 丢了,也可能是只是延迟而不是丢了)
- 接收方在 ACK 中显式写明所确认的分组
- 如果分组或 ACK 只是延迟而不是丢了,重传会产生重复,序列号机制能够处理
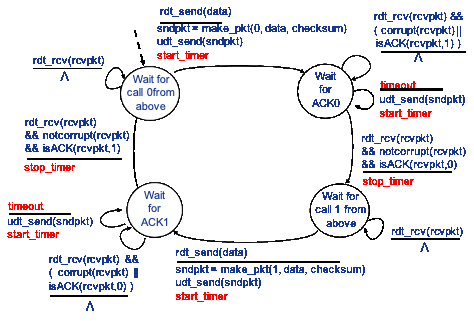
Rdt3.0 工作时的时序如下(有4种情况):
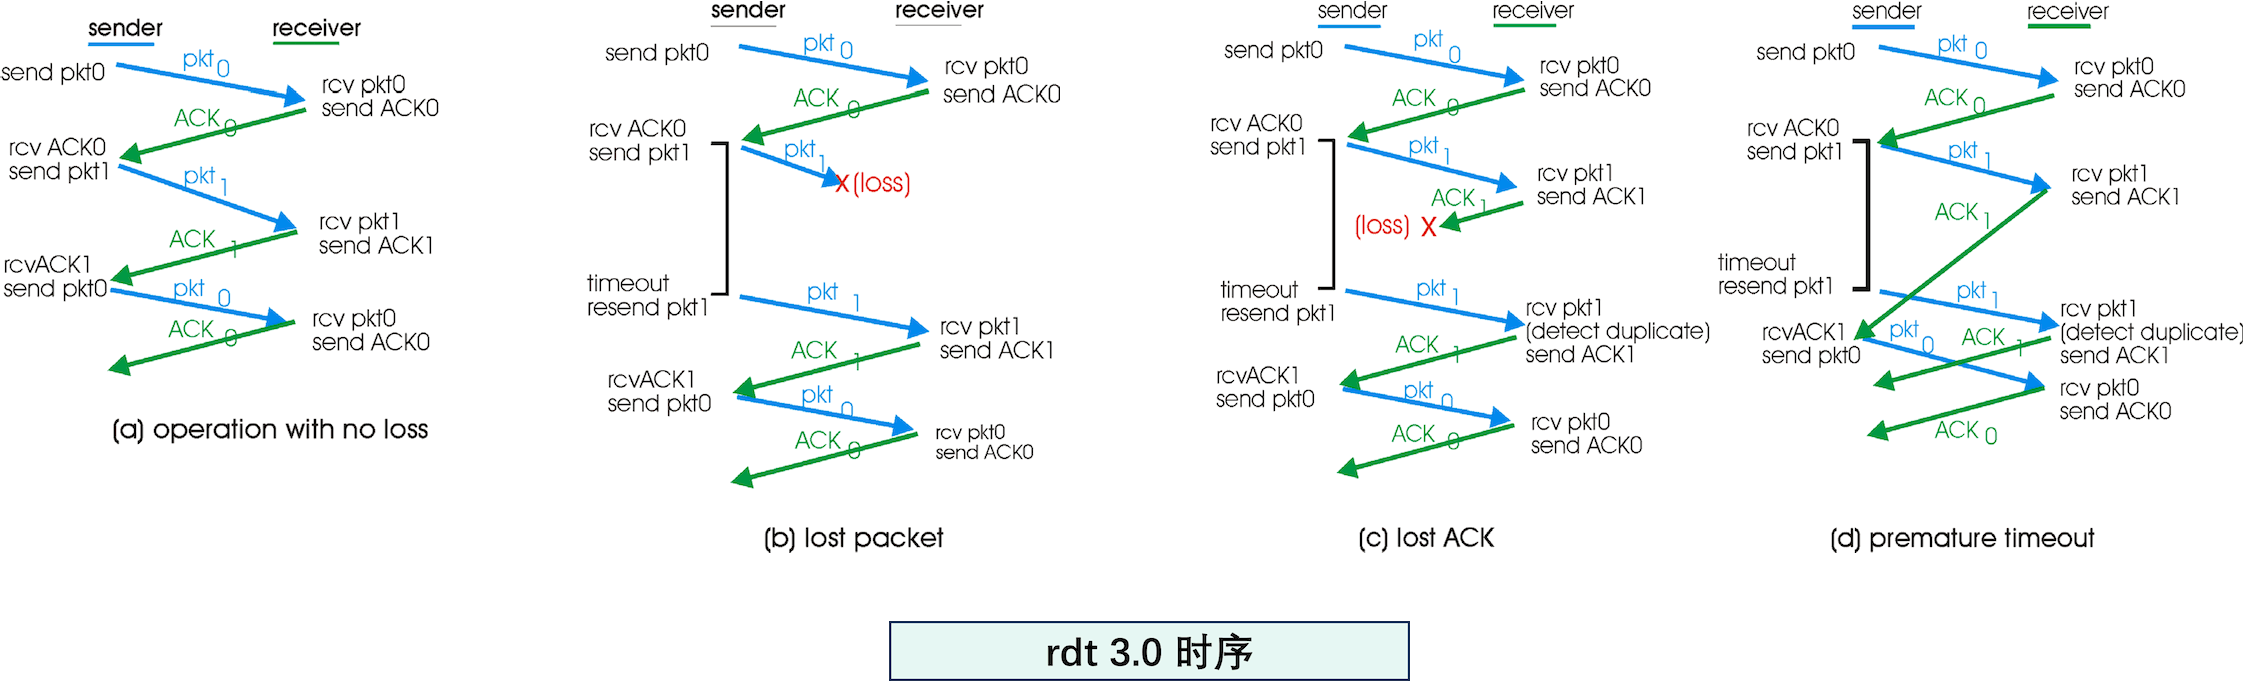
共有4种情况
- (a) 正常传输
- (b) 包丢失/有误
- 传输方等待超时,重发分组
- (c) ACK 丢失/有误
- 传输方等待超时,重发分组
- 接收方检测到重复分组,发送 ACK
- (d) 延迟
- 传输方超时重发
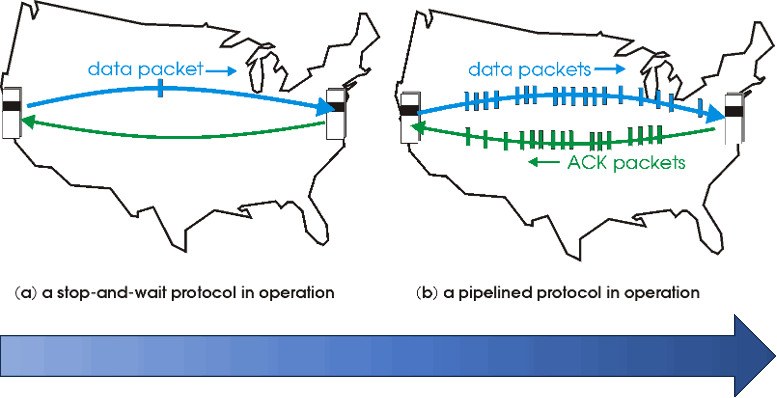
Rdt3.0的性能很差
- 示例:1Gbps链路,15ms端到端传播延迟,1KB分组
- 发送一个包的时间 $T_{t} = L/R = 1kB/1Gbps = 0.008 ms$
- 发送方利用率 $= \dfrac{L/R}{RTT+L/R}= \dfrac{0.008}{30+0.008}=0.00027$
- 每个分组的发送时间为 30.008 ms,也就是说,实际带宽仅为 33KB/s
流水线协议:解决性能问题
- 更大的 序号范围(有限的范围内循环,即模运算)
- 发送方/接收方 需要更大空间以 缓存分组
- 为了控制,需要 滑动窗口协议:GBN、SR
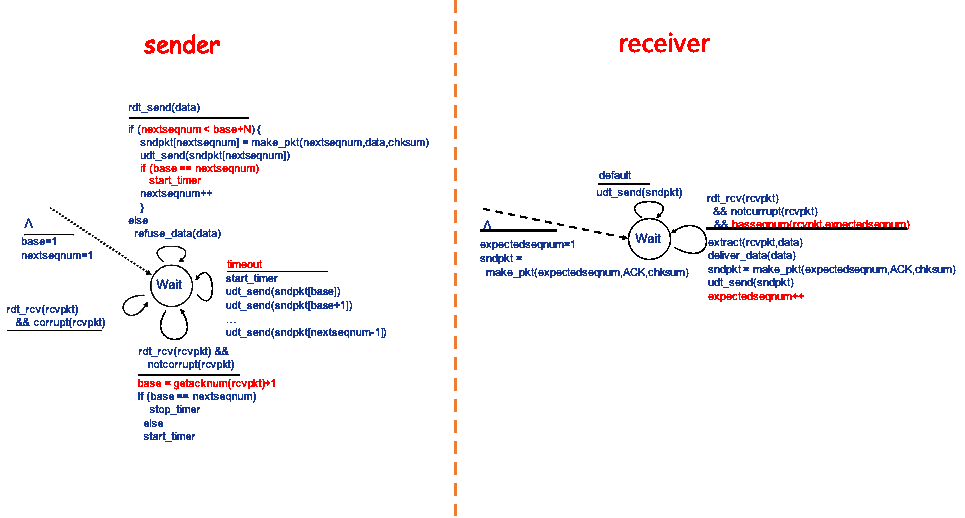
GBN协议 (Go-Back-N)
- 发送方
- 分组头部包含序列号
- 窗口为尺寸 N:最多允许N个未确认的分组
- ACK(n):代表n之前(包含n)的分组都已被正确接收
- 可能收到重复的 ACK
- 为空中的分组设置 计时器(timer)
- 超时 timeout(n) 事件:重传序号大于等于n,还未收到 ACK 的所有分组
- 接收方
- ACK机制: 发送拥有最高序列号的、已被正确接收的分组的ACK
- 乱序到达的分组:
- 直接丢弃
- 重新确认序列号最大的、按序到达的分组的 ACK
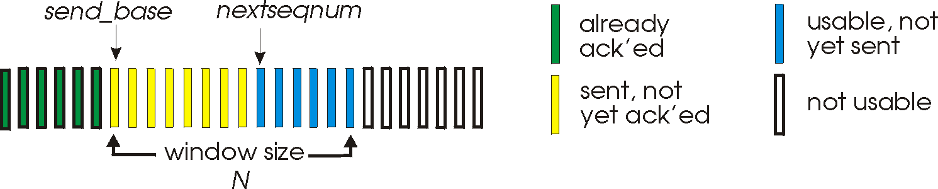
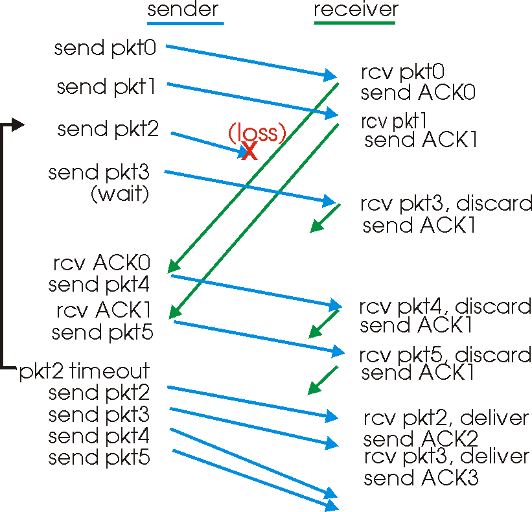
GBN的例子:
- 发送方已经发送了编号为0~7的帧。当计时器超时时,若发送方只收到0、2、3号帧的确认,则发送方需要重发哪几个帧?
- 需要重发4、5、6、7号帧
- 可能已经往回发送了
ACK(1),但是丢包了
GBN的缺陷:当 n 错误时,需要重传 n 之后的所有分组,导致网络上充斥很多重传的分组
SR协议(select repeat):
- 接收方
- 每个分组单独确认并发送各自的 ACK
- 乱序到达的分组,不丢弃,而是 缓存,并且发送 ACK(GBN会丢弃)
- 发送方
- 只重传没收到 ACK 的分组(GBN会重传)
- 每个分组单独有计时器
- 发送方窗口,最大为 N
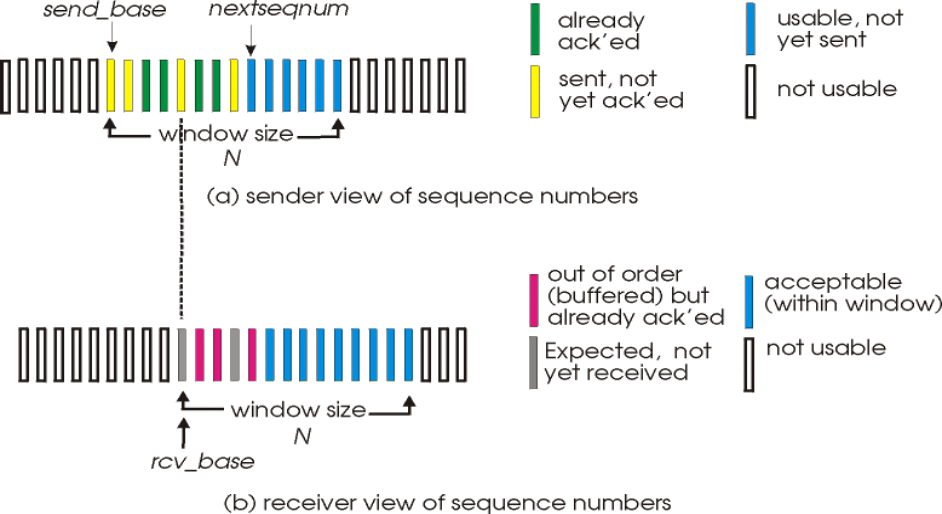
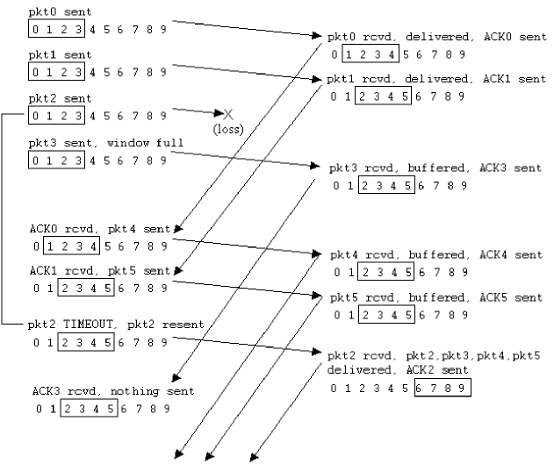
SR 的某个困境:假设窗口尺寸为 N,使用的序列号为 0~N-1,那么由于有很多空中的包,因此序号容易搞混
- 解决:假设序号空间为 k,发送方和接收方窗口大小为 $N_S,S_R$,那么必须满足 $N_S+N_R\leq 2^k$
TCP
TCP RFC793, 1122, 1323, 2018, 2581
- 点对点:一个发送方,一个接收方
- 提供:可靠的、按序的字节流
- 建立在IP层提供的不可靠信道上
- Seq、ACK
- 定时器
- 重传
- 流水线机制
- 发送方/接收方缓存
- 全双工(full-duplex)
- 同一连接中能够传输双向数据流
- 面向连接
- 通信双方在发送数据之前必须建立连接。
- 连接状态只在连接的两端中维护,在沿途节点中并不维护状态。
- TCP连接包括:两台主机上的缓存、连接状态变量、socket等
- 流量控制机制
- 拥塞控制
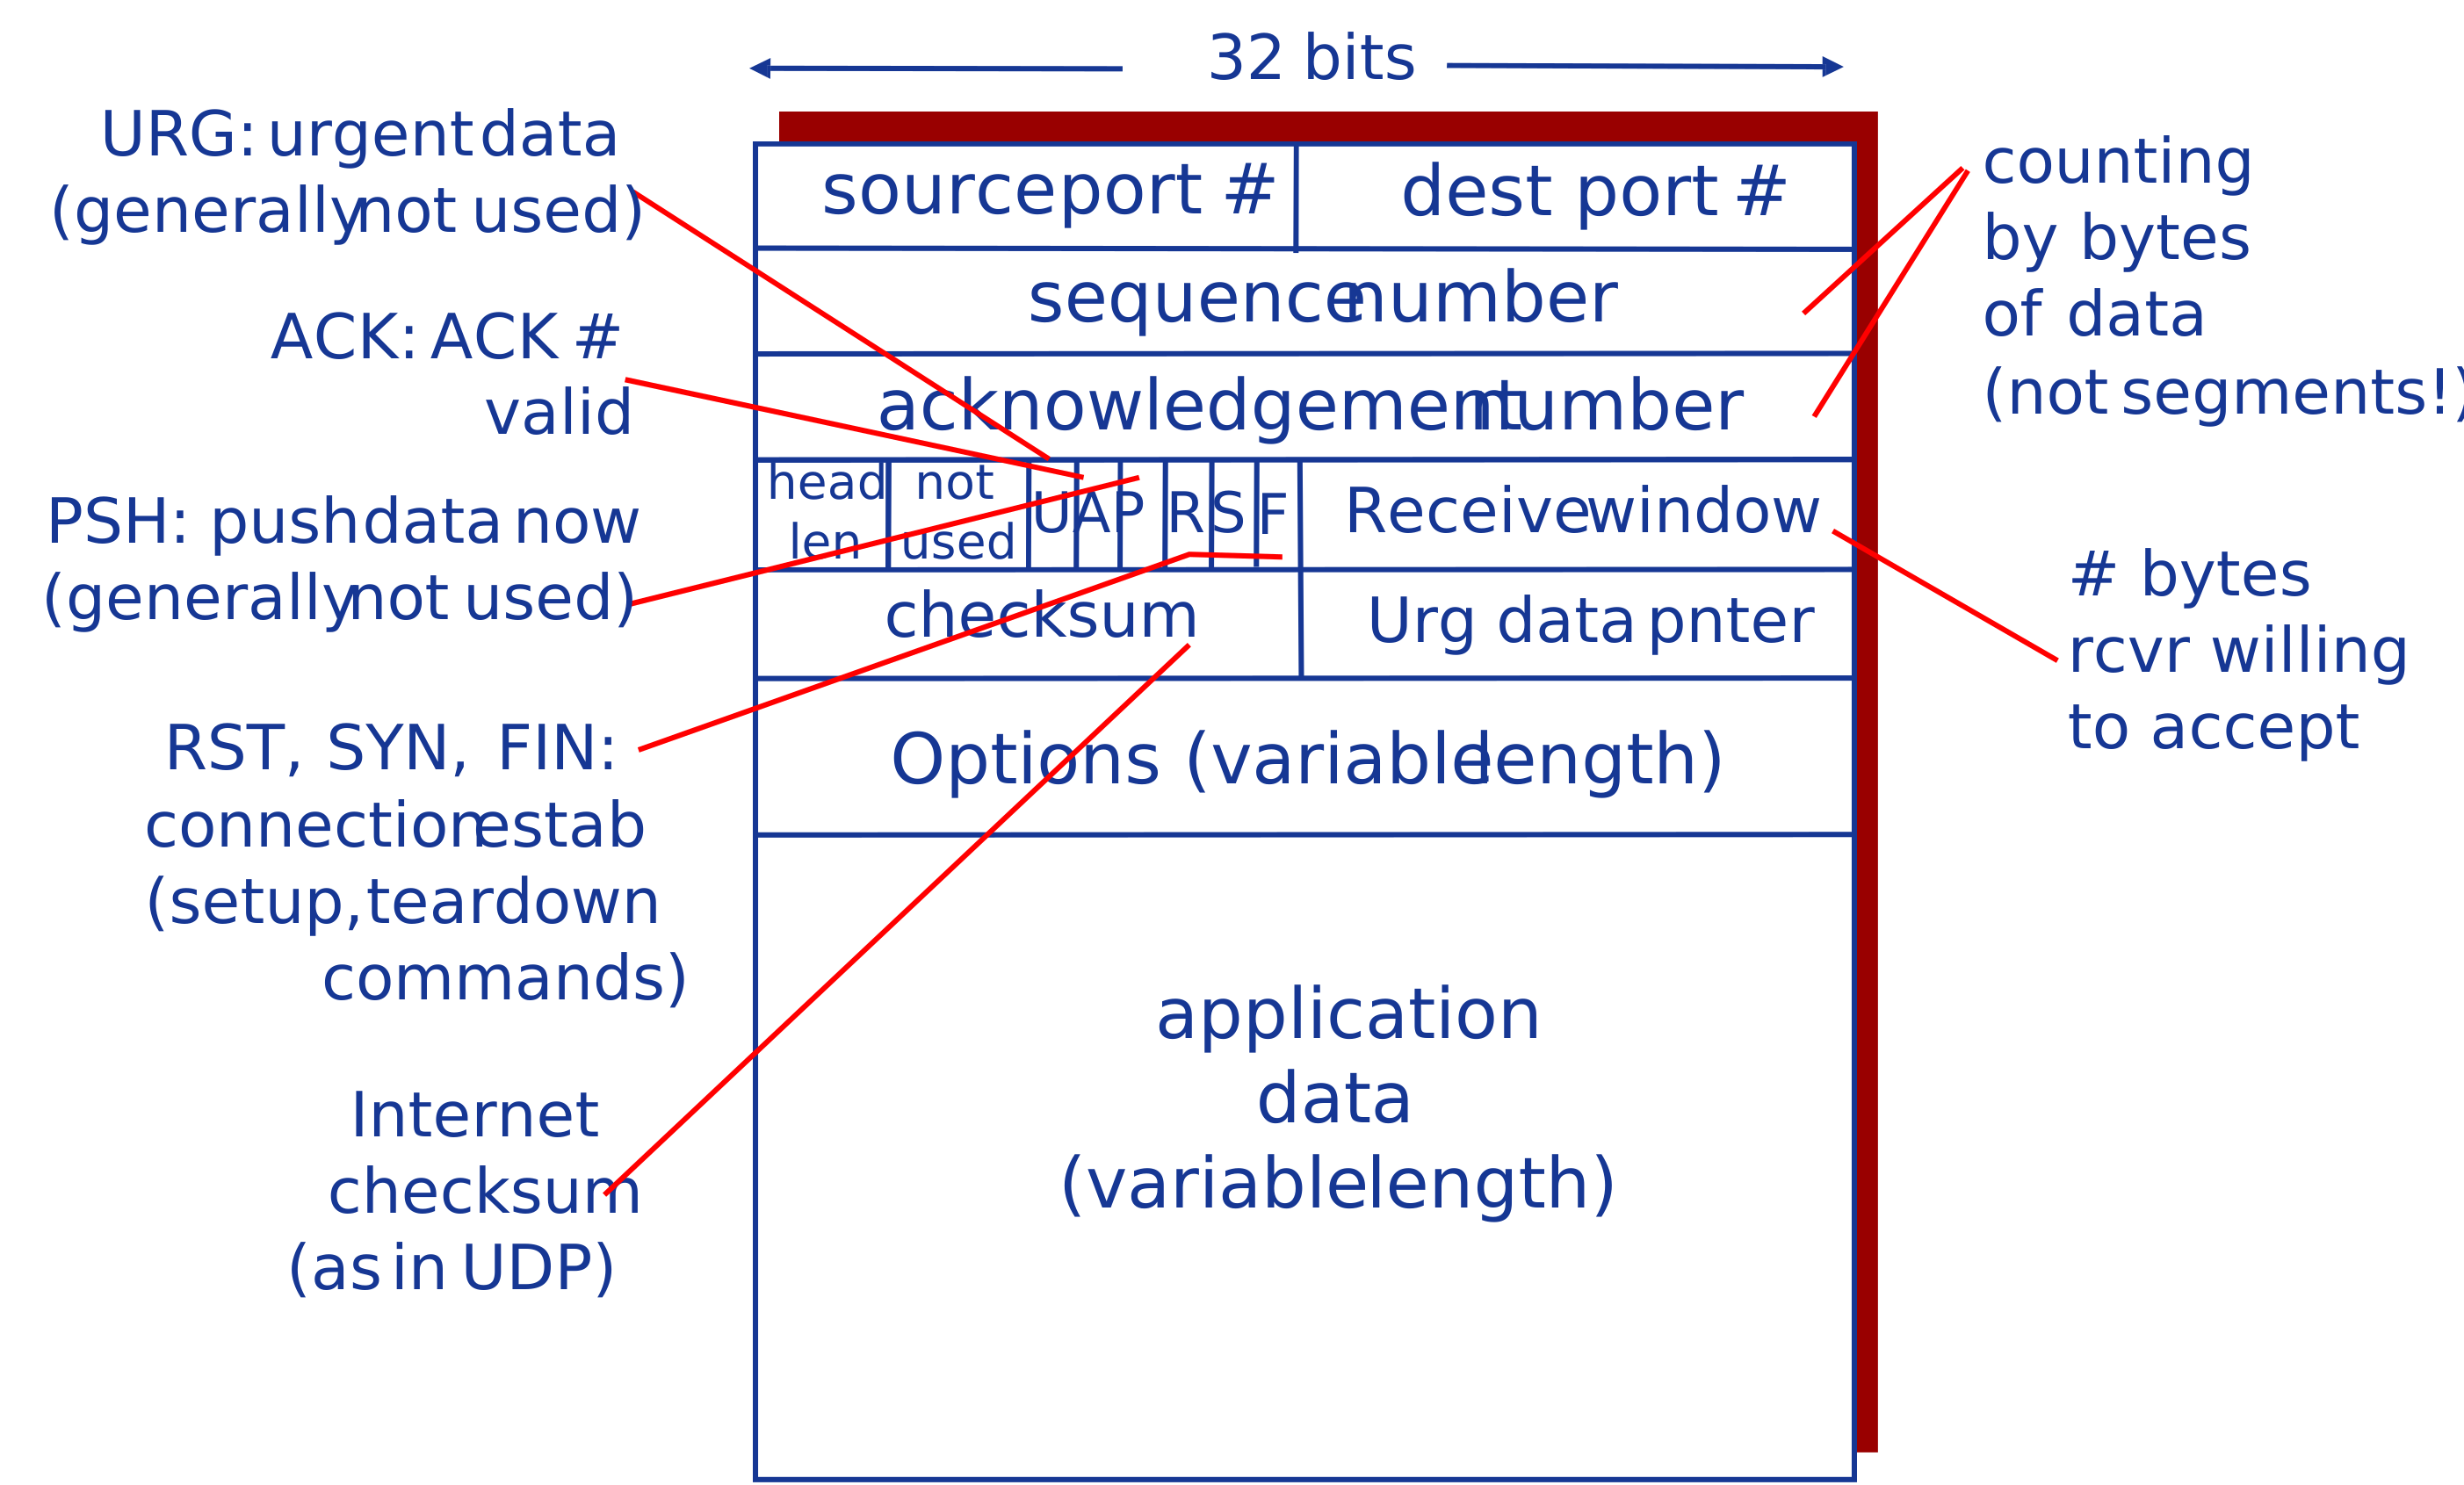
Seq(Sequence Number,序号)
- segment 中第一个字节的序号(注意,不是 segment 编号)
- 建立 TCP 连接时,双方随机选择序列号
- 举例
- 某个 TCP 的 Segment:
Seq = 1000; Payload = 500,那么它携带的是字节 1000~1499 - 下一个 TCP 段应当是
Seq = 1500
- 某个 TCP 的 Segment:
ACK:
- 接受方发送:希望收到的下一个字节的序号
- 累计确认:该序号之前的所有字节都已经被正确接收到
- 例如,收到了
1000~1499, 2000~2499,接收方仍然回复ACK = 1500 - 现代 TCP 的重要扩展 SACK(Selective Acknowledgment,选择确认),接受方回复:
ACK = 1500; SACK: 2000~3000 已收到
其它要点
- 两个方向(
A -> B和B -> A) 其 Seq 和 ACK 是各自独立计算的 - 初始 Seq 不是从 0 开始的
- 这是因为:1)避免旧连接报文玉新连接混淆;2)提升协议健壮性和安全性
- Seq 是 32bit,其最大值为
1 >> 32 - 1,达到最大值后取模 - 纯 ACK 本身不消耗序号,因为它的
len(PayLoad) = 0 - 三次握手中的
SYN和FIN都会消耗 Seq - Receiver:不是每次收到 Segment 都会发送 ACK:而是等待 500ms,看有没有下一个 Segment 到达。累积2个 Segment 就不再等待,立即发送 ACK。(减少 ACK 数量)
乱序到达的 Segment:TCP 规范没做规定,TCP 实现者自己做出决策
定时器
如何设置定时器的超时时间?
- ❌ 基于 RTT?但是 RTT 是变化的
- ❌ 过短:不必要的重传
- ❌ 过长:对段丢失反应慢
设置定时器的算法:指数平滑
- 估算 RTT
- 测量段发出到收到 ACK 的时间
- 多次测量,计算指数加权平均(指数平滑)
EstimatedRTT = (1−α)EstimatedRTT + α SampleRTT
- 估算 RTT 的 标准差
DevRTT(同样用指数平滑计算) - 超时时间 =
EstimatedRTT + 4 * DevRTT
快速重传机制
- 为什么?等待超时再重发,往往会等待很久
- 再加上,如果之前已经发生过超时,超时时间会重新加倍设置
- 这就导致整体性能很差
- 解决思路:流水线机制下,如果某个 Segment 发送超时,Receiver 就可能收到多个重复的 ACK
- 这是因为,后续的 Segment 到达后,Receiver 仍然会 发送缺失的那个 Segment
- 如何做:
- 如果 Sender 收到3个相同的 ACK,则假定该数据之后的 Segment 都已经丢失
- 快速重传:定时器超时之前就重传
(如果支持 SACK,重传会更精确)
流量控制(Flow Control)
- 目的:防止 Sender 发得太快,把 Receiver 的接收缓冲区撑爆。
- 原因可能有这些:
- 应用处理太慢
- Segment 乱序到达,前面有缺口而无法及时交付给 应用层。(因为 TCP 要保证自己是有序的,把缺口填满才有序给到应用层)
- 原因可能有这些:
- 如何做?接收者的 ACK 中有参数
Receive window(rwnd),用来告诉发送方缓存区还剩多少
一个死锁的情况:
- 接收者的
rwnd = 0(零窗口状态),并且发送了 ACK,这时 Sender 停止发送数据; - 之后接收者把缓冲区的信息处理完毕,然后发送一个 ACK:
rwnd = 5000,但这个 ACK 恰好丢了,这就产生了 死锁。Sender 以为 Receiver 缓冲区一直是满的,Receiver 一直在等待继续发送。 - 解决方案:发送方会在零窗口状态下周期性发送 零窗口探测(Zero-Window Probe),以探测 Receiver 的缓冲区是否有空间
TCP连接管理(Connection Management)
- 三次握手(Three-Way Handshake):建立 TCP 连接
- 四次挥手(Four-Way Termination):关闭 TCP 连接
三次握手 以 A(Client) 向 B(Server)发起链接为例
- A 发送 SYN
- A 确定 初始序列号(Initial Sequence Number, ISN),有很多机制来确定它
- 不含数据
- 假设
Seq = x
- B:SYN ACK
- 确定 ISN,假设
Seq = y - 发送:
SYN + ACK, Seq = y, ACK = x + 1
- 确定 ISN,假设
- A:ACK
- 发送:
ACK, Seq = x + 1, ACK = y + 1 - 可以包含数据
- 发送:
为什么是3次握手而不是2次握手?
- 情况一:第二个 ACK 丢失
- B:连接已建立
- A:????我没收到你的回复
- 情况二:幽灵链接
- A 发送 SYN,由于网络延迟很久之后才到达 B,这时 A 如果已经不想建立链接了
- B:发送 SYN + ACK,并建立连接。这是个本不应该存在的连接。
四次挥手
- 最后一步需要等待,这是因为最后一个 ACK 一旦丢失,B 会认为 FIN 可能未收到,而重发
- 另外,如果不久后又有新连接,同时旧的 Segment 还在网络里,就可能干扰新连接
拥塞控制(Congestion Control)
- Sender 发送速度太快,以至于网络无法处理(与 流量控制 区别)
- 分组丢失(路由器缓存溢出)
- 分组延迟过大(在路由器缓存中排队)
- 如果不做拥塞控制会怎样?
- 即使中间路由器又无限 buffer,也会导致其排队无限多,进而使 delay 无限高
- 实际中间路由器的 buffer 有限,拥塞导致丢失、延迟,会触发更多的 重传,进一步导致网络瘫痪
- 对于多跳的网络,当某个路由节点 drop 掉某个 Segment 时,处理这个 segment 的所有上游的能力全部浪费掉了
- Sender 如何知道网络拥塞了
- 丢包:Timeout、3个重复 ACK
- RTT 增大
拥塞控制思路(2种)
- 端到端的拥塞控制
- 两台机器通过观察 loss、delay 等网络行为,判断是否发生拥塞
- 网络层不显式提供支持
- TCP 采取这种方法
- 网络辅助的拥塞控制
- 路由器反方向向发送方显式发送网络拥塞相关信息
- 简单的拥塞指示(1bit):SNA, DECbit, TCP/IP ECN, ATM
- 指示发送方应该采取何种速率
TCP 拥塞控制的思路:
- 试探网络容量,加法增长、乘法下降。
- TCP 拥塞控制调整的是 拥塞窗口(Congestion Window, cwnd):根据当前网络状况,我认为最多可以有多少数据在网络中“飞着”
TCP 拥塞控制算法:
- 慢启动(Slow Start):一开始每个 RTT 发送 1MSS(Maximum Segment Size,最大报文段长度),之后每次指数翻倍
- 目的是启动后快速攀升
- 拥塞避免(Congestion Avoidance):指数增长到一定程度后(ssthresh,Slow Start Threshold,慢启动阈值),切换到线性增长
- 如果发生超时:
- 设定
ssthresh = cwnd / 2 - 然后从
cwnd = 1 MSS开始慢启动
- 设定
- 快速重传(Fast Retransmit)、快速恢复(Fast Recovery)
- 如果收到3个重复的 ACK,说明网络没有完全堵死,不能像处理超时一样激烈
cwnd = cwnd / 2,继续线形增长试探
一些问题
关于网络性能的问题。看起来锯齿状流量,使带宽利用率为 75%(甚至更小)?
- 不是的,不止是看
cwnd,关键是看 带宽时延积(Bandwidth-Delay Product, BDP) - 即使
cwnd减半,很大概率仍然有足够的数据填满整个网络管道。 - 说明性能损失没有上面计算的那样高。不过确实后续有更先进的的拥塞控制算法,尽量充分利用网络带宽。
TCP 公平问题
- TCP 之间公平吗?是的,如图,会逐渐收敛到公平线上
- TCP+UDP共存?不公平,UDP 更占便宜,因为 UDP 没有拥塞控制。
- 并发 TCP 呢?不公平。原本有 10个 TCP 链接,某个新应用新开 10个 TCP连接,可能就直接占用一半带宽
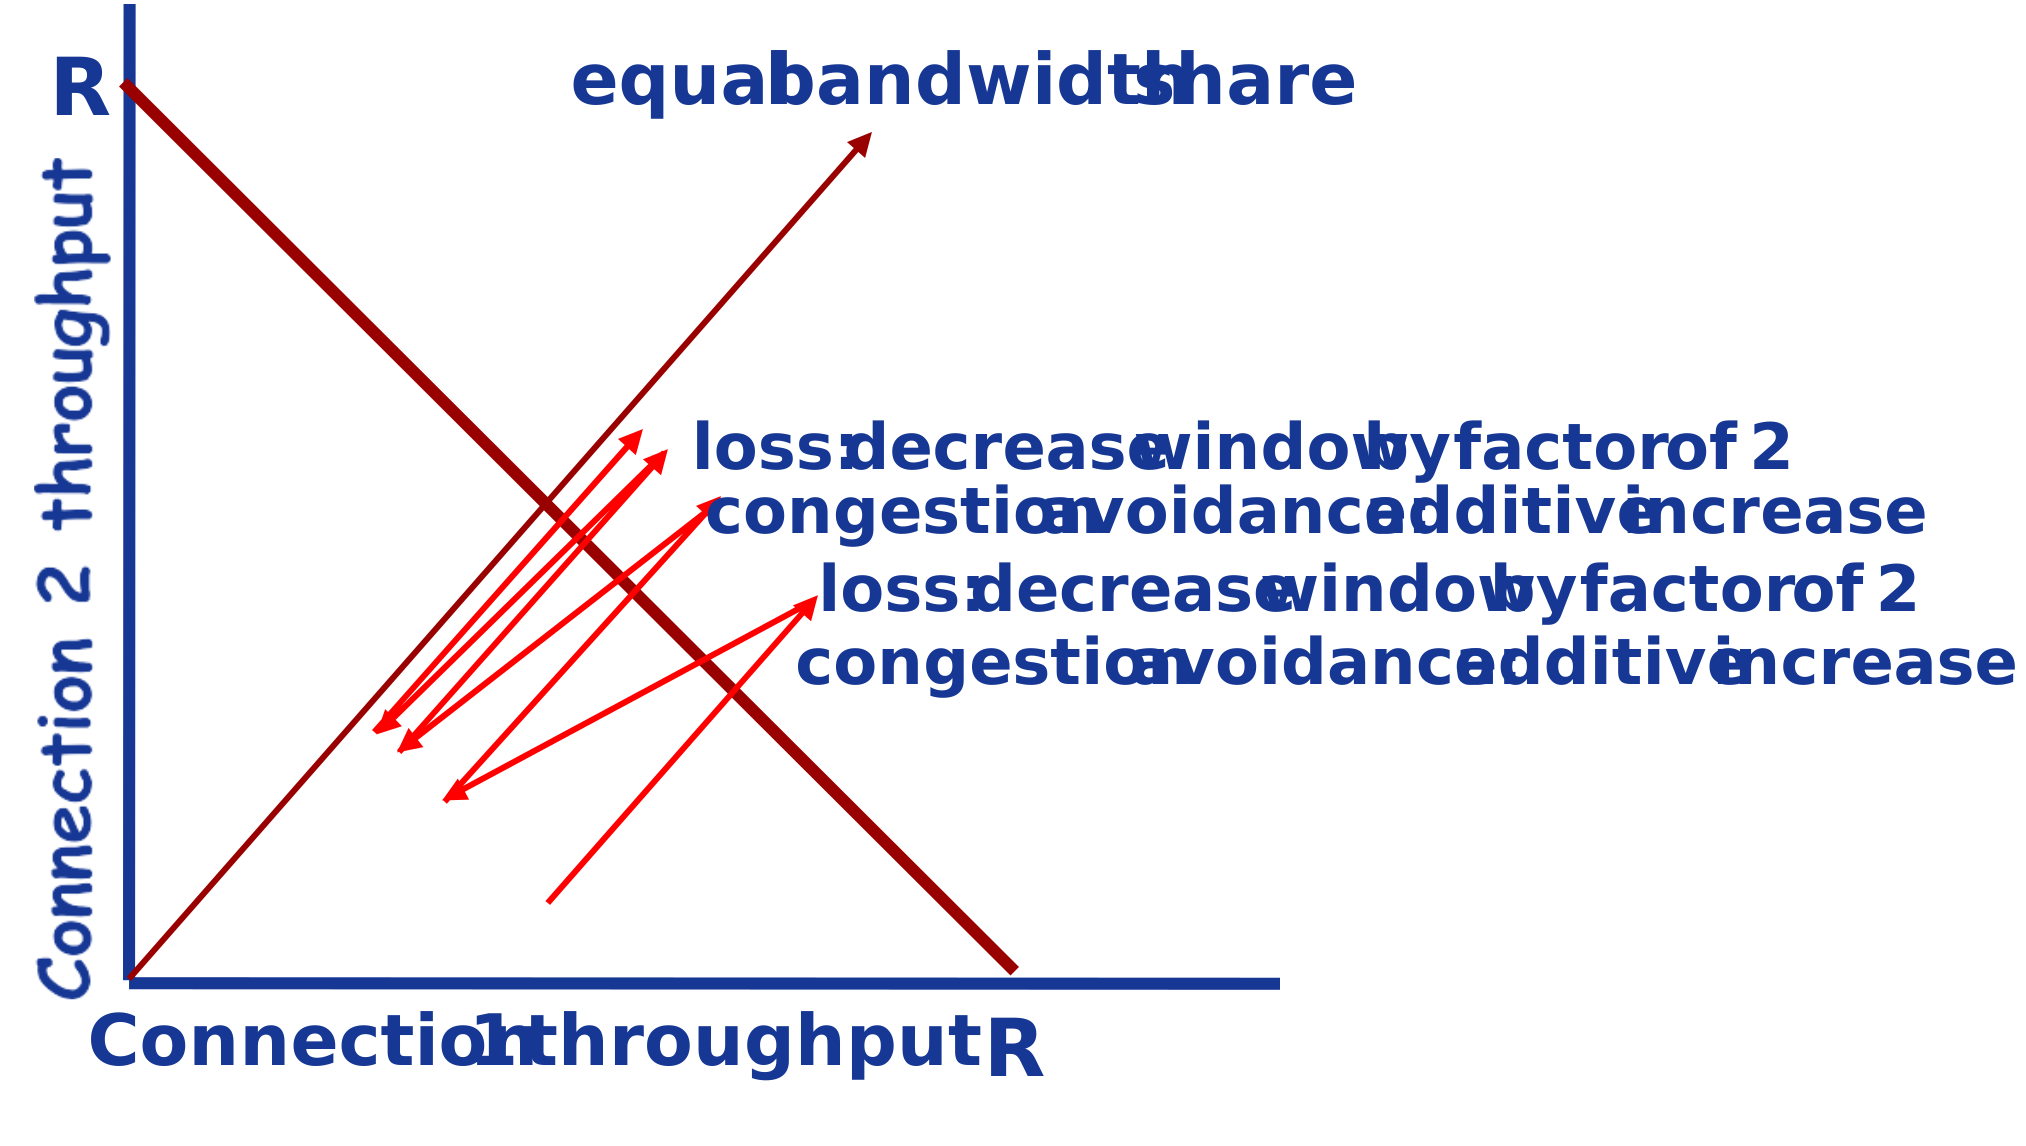
网络层
网络层做什么
- 发送端:接收 segment,封装为 datagram
- 路由器:按照路由算法,接收并转发 datagram
- 接收端:接收 datagram,转发 segment
网络层的核心功能
- 转发(forwarding): 将分组从路由器的输入端口转移到合适的输出端口
- 路由器维护一个转发表
- 路由(routing): 确定分组从源到目的经过的路径
- 路由算法 (routing algorithms)
- 连接建立
(除了 internet 之外,还有各种个样的网络结构,如 ATM,它们的特点是保证不同的属性:bandwidth, loss, order, Timing, Congestion feedback 等)
虚电路网络与数据报网络
网络层服务模型(2类)
- 无连接服务(connection-less service):
- 数据报网络(datagram network)
- 每个 datagram 独立携带目的地址
- 独立查转发表
- 路径可能不同
- 路由器不维护连接状态
- 典型代表:IP(IPv4,IPv6)
- 连接服务(connection service):
- 虚电路网络(virtual-circuit network)
- 先建立连接:确定从 src 到 dst 的路径
- 然后沿该路径(连接)传输系列分组
- 每个分组传输路径相同
- 传输结束后拆除连接
- 典型代表:X.25, Frame Relay(帧中继), ATM(Asynchronous Transfer Mode,异步传输模式)。Internet 不采用此方式
虚电路:一条从源主机到目的主机,类似于电路的路径(逻辑连接)
- 分组交换
- 每个分组的传输利用链路的全部带宽
- 路径上的每个设备(如路由)都参与维护连接状态
- 转发表
一个虚电路有:
- 从源主机到目的主机的一条路径
- 虚电路号(VCID)
- 这个 ID 是局部的,不是端到端全程不变的(虚电路表转发映射)
- 沿路每个设备(如路由器),利用转发表记录经过的每条虚电路
- 沿某条虚电路传输的分组,携带对应虚电路的VCID,而不是目的地址
- 同一条VC ,在每段链路上的VCID通常不同
- 路由器转发分组时依据转发表改写/替换虚电路号
虚电路信令协议(signaling protocols):用于VC的建立、维护与拆除
数据报网络
转发表:
- 维护一个全 IP 的转发表不可能(32位的 IP,对应40亿条转发表)
- 考虑维护较小的转发表,用一个地址范围聚合
例如,一个转发表的例子
| 目的地址范围 | 链路接口 |
|---|---|
| 11001000 00010111 00010xxx xxxxxxxx | 0 |
| 11001000 00010111 00011000 xxxxxxxx | 1 |
| 11001000 00010111 00011xxx xxxxxxxx | 2 |
| 其它 | 3 |
匹配原则:最长优先
- 当一个地址可以匹配多条规则时,选择前缀最长的那个
IPv4 和 IPv6
Internet 网络 的核心协议
- 路由协议(Routing Protocol):负责路径选择
- RIP(Routing Information Protocol), OSPF(Open Shortest Path First),BGP(Border Gateway Protocol)
- IP 协议(Internet Protocol):负责运送 datagram
- 定义 IP 地址
- 定义 IP datagram 格式
- 路由器根据目的 IP 地址进行转发(Forwarding)
- ICMP(Internet Control Message Protocol,互联网控制报文协议):负责“报告网络运行状态和错误”
IP datagram(IP数据报)
- 版本号:(4bit)IP 协议的版本号,
4或者6 - 首部长度:(4bit)IP 分组的首部长度。其单位是 4Bytes,例如
5代表首部长度为 20Btyes- 首部长度最小是 20Bytes(固定部分)
- 服务类型:(8bit)指示期望获得哪种类型的服务。绝大部分路由不起作用
- 总长度:(16bit)整个IP datagram 的总字节数。最大是 65535
- 标识、标志、片偏移:与 IP 分片 相关(后面详细写)
- 生存时间(TTL):(8bit)datagram 最多可以还可以通过多少个路由器
- 每经过一次路由转发,TTL 减 1
- 如果 TTL = 0,路由器丢弃此 datagram(通常会反向发送 ICMP 报文)
- 协议(8bit):此 datagram 封装的是哪个协议的数据包
- 6 为 TCP
- 17 为 UDP
- 首部校验和
- 计算时,此字段置0,然后对首部计算(只校验首部)
- 算法:反码求和,然后再反码
- 每一跳都计算、校验
- 源IP地址、目的IP地址(各32bit)
- 选项字段(0-40B之间):实际很少使用,安全、路径、时间戳、路由记录等内容
- 填充(0-3B之间):使其符合32位对齐
IP分片(IP fragmentation):一个 IP datagram 太大,超过了下一段链路允许承载的最大大小(MTU,Maximum Transmission Unit,最大传输单元),于是被拆成多个更小的 IP datagram 分别传输。
- 分片后的每个 fragment 自己都是一个完整的 IP datagram
- 它们各自经过网络
- 最后由目的主机重组(reassembly),恢复成原始 IP datagram。
- 如果目的主机在一段时间内没有等到全部分片,则会将分片全部丢弃
- 路由没有重组功能,只有目的主机有
- 如果原始 IP datagram 规定不许被分片,路由器丢弃,并反向发送 ICMP
- Ethernet 常见 MTU 是 1500B
如何进行 IP 分片?依靠 IP datagram 的这些字段:
- 标识(ID)(16bits):连续的自增整数,与“源IP地址”、“目的IP地址”、“协议”等一起作为唯一标识
- 分片后的标识,填入分片前的标识
- 标志位(3bits):
【保留】【DF】【MF】- DF (Don't Fragment):
DF = 1:禁止分片;DF = 0:允许分片 - MF (More Fragment):
MF = 1:非最后一片;MF = 0:最后一片(或未分片)
- DF (Don't Fragment):
- 片偏移(13bits):一个 IP 分片,在原 IP datagram 中的相对偏移量
- 如果未经过分片,其值为0
- 其值以 8Bytes 为单位(因此分片后的字节数一定是 8的倍数,除了最后一片)
- 长度:分片后的长度,填入分片后的实际值
例子:
- 假设原 IP datagram 长度为
L,下一个链路的 MTU 为M,首部为 20,且之前未经历过分片 - 如果
L > M and DF = 0,则需要分片,且允许分片 - 标识复制原来的 IP datagram 的标识
- 通常,除了最后一个分片,其它分片的大小均为 MTU 允许的最大分片(但 payload 应当是 8 的倍数)
- 因此分片后,其最大可封装数据量为
d = (M - 20) // 8 * 8 - 需要的总片数为
n = ceil((L - 20) / d) - 第 i 个分片的片偏移量为 $F_i=\frac{d}{8}(i-1),\quad 1\le i\le n$
- 每片的总长度 \(L_i= \begin{cases} d+20, & 1\le i<n\\ L-(n-1)d, & i=n \end{cases}\)
- 每一片的标志位 \(MF_i= \begin{cases} 1, & 1\le i<n\\ 0, & i=n \end{cases}\)
IP编址(addressing)
- IPv4: 32bits(或者4个Byte)
- IP地址与每个接口关联(接口的IP地址)
- 常说xx主机的IP地址,是因为一台主机通常只有1个接口
- 路由器有多个接口
- 为了不让转发表过于复杂,IP 地址遵守一些规则
- 前x位为 网络号(NetID),后y位为 主机号(HostID)
- IP子网(subnet):有相同 NetID 的设备,它们之间 不可跨越路由
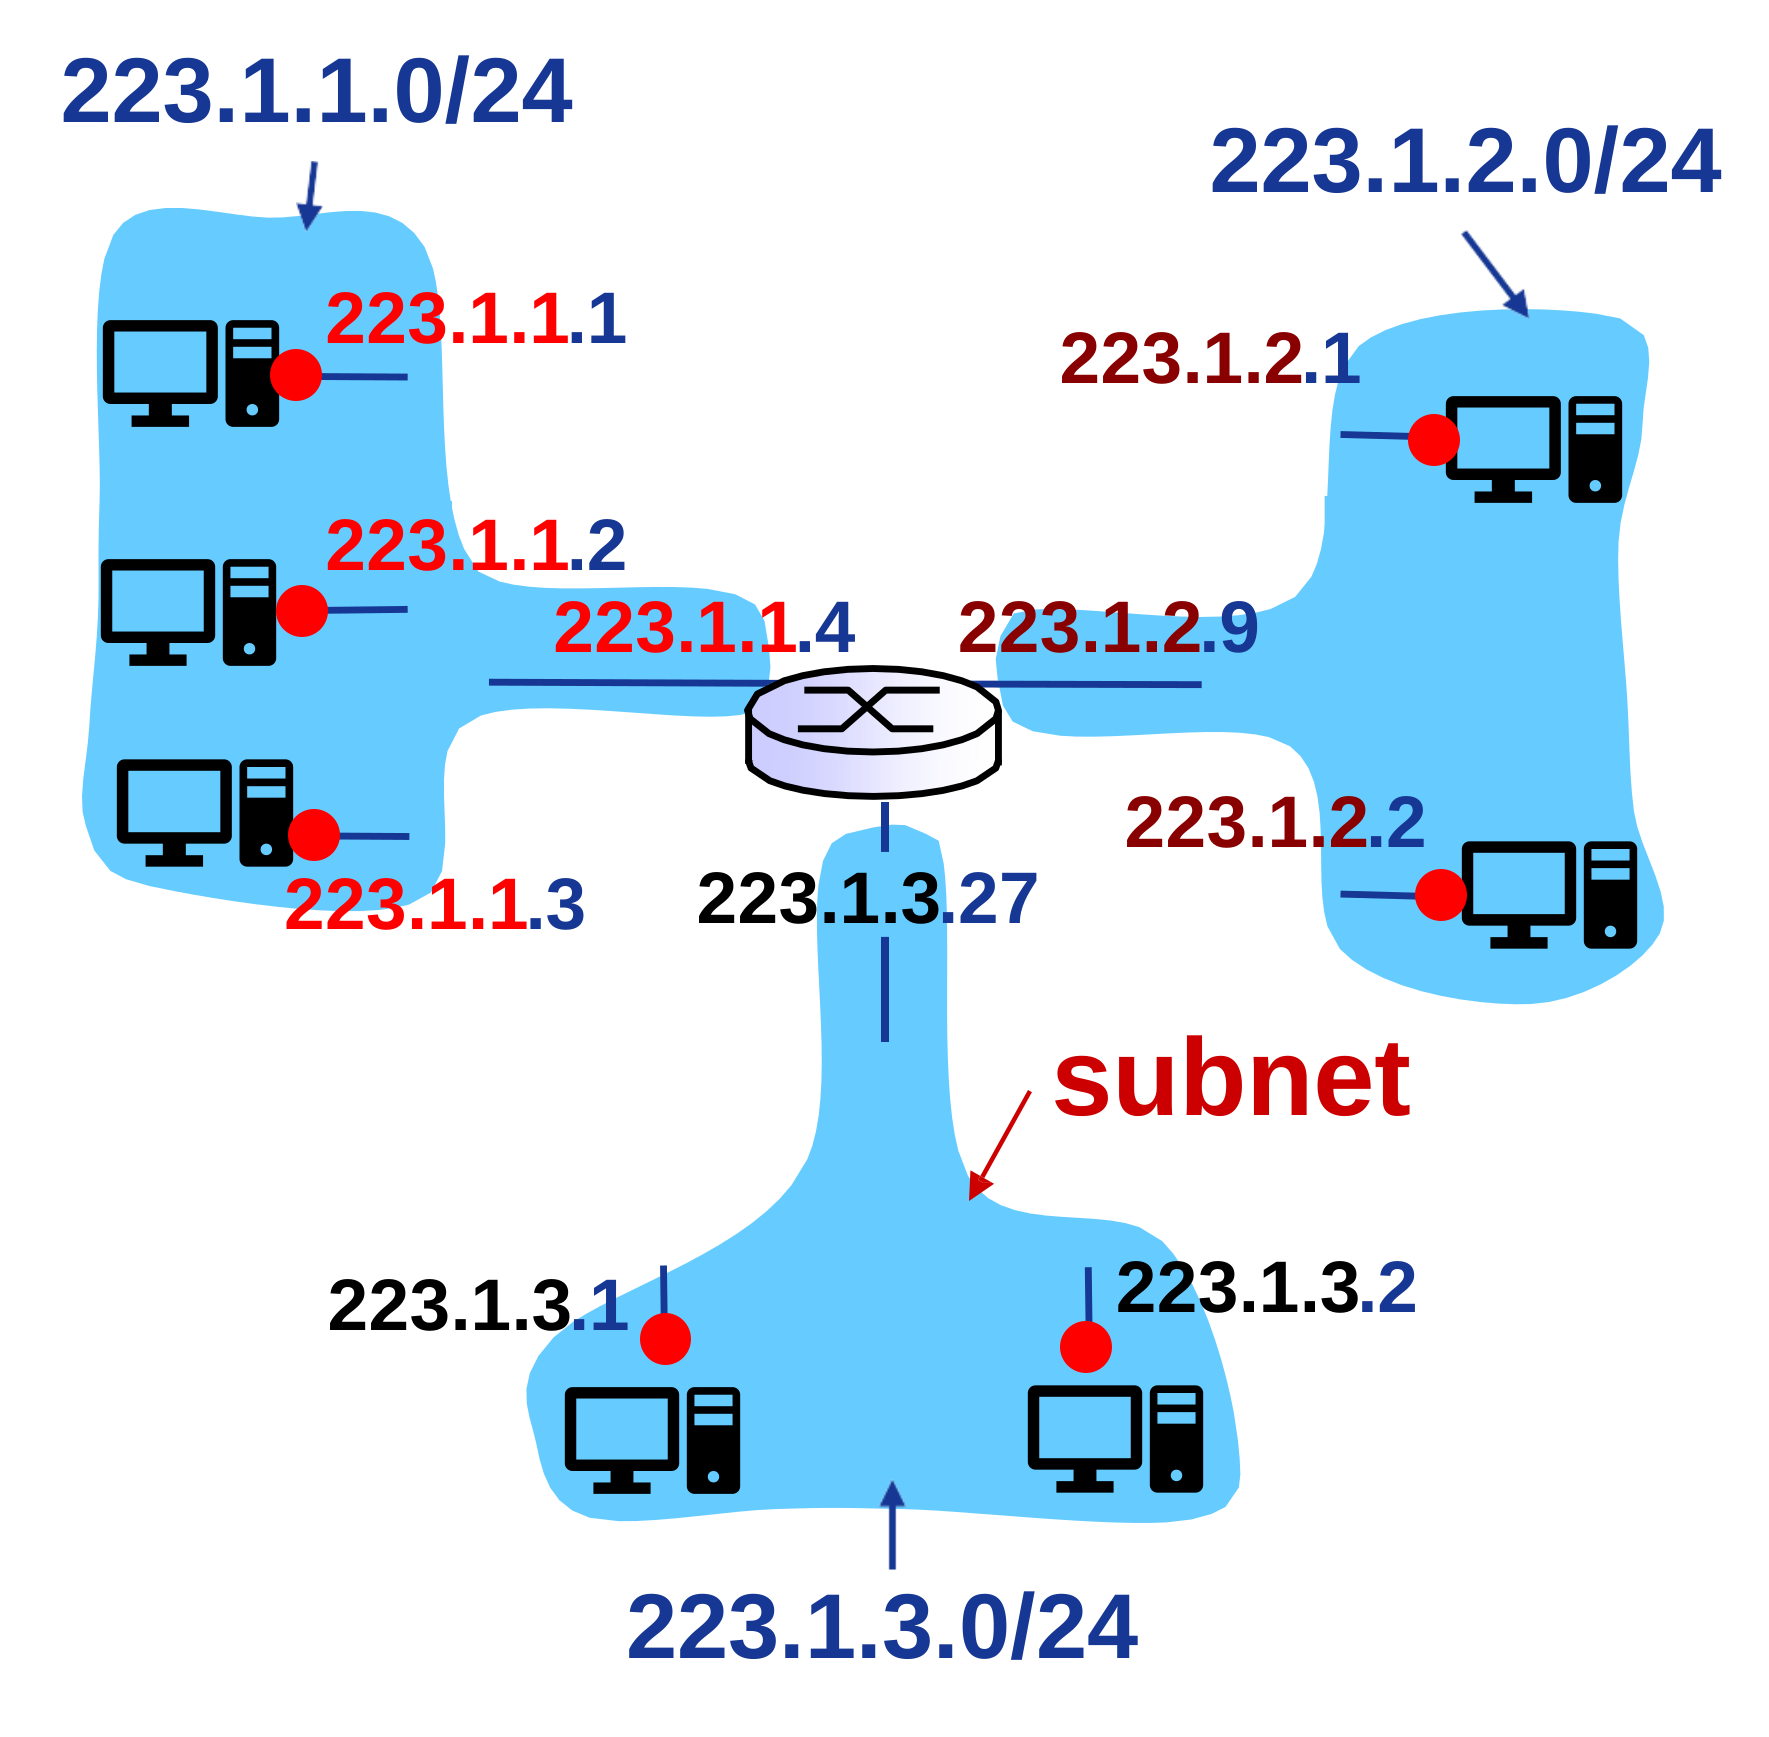
“有类”编址
| 类别 | 最高位模式 | 第一个字节范围 | NetID 长度 | HostID 长度 | 默认子网掩码 |
|---|---|---|---|---|---|
| A 类 | 0 |
1–126 | 8 bit | 24 bit | 255.0.0.0,即 /8 |
| B 类 | 10 |
128–191 | 16 bit | 16 bit | 255.255.0.0,即 /16 |
| C 类 | 110 |
192–223 | 24 bit | 8 bit | 255.255.255.0,即 /24 |
| D 类 | 1110 |
224–239 | — | — | 多播(Multicast) |
| E 类 | 1111 |
240–255 | — | — | 保留/实验用途 |
CIDR
- “有类”编址的问题:某机构需要1000个地址,它不能申请C类(只有254个),只能申请 B类(有 65534个,浪费)
- CIDR 用类似
192.168.0.0/20的/20来表示 NetID 长度
一些特殊IP:
| NetID | HostID | 可作源地址 | 可作目的地址 | 含义 |
|---|---|---|---|---|
| 全 0 | 全 0 | 可以 | 不可以 | 0.0.0.0 本网范围内表示本机;路由表中表示默认路由(整个 Internet 网络) |
| 全 1 | 全 1 | 不可以 | 可以 | 255.255.255.255,本网广播(路由器不转发) |
| 特定值 | 全 0 | 不可以 | 不可以 | 网络地址(Network Address),表示一个 subnet 地址 |
| 特定值 | 全 1 | 不可以 | 可以 | 定向广播(Directed Broadcast) 对特定网络上的所有主机广播 |
127 |
非全 0 非全 1 的任何数 | 可以 | 可以 | 环回地址(Loopback Address) 用于本地环回测试 |
还保留了一些私有地址(Private IP),它们只在本地有效,在公共互联网上是无效的
| Class | NetID |
|---|---|
| A | 10 |
| B | 172.16 - 172.31 |
| C | 192.168.0 - 192.168.255 |
子网划分:把较大的IP网络,且分成更小的网络。目的是合理划分子网规模,便于网络隔离和管理
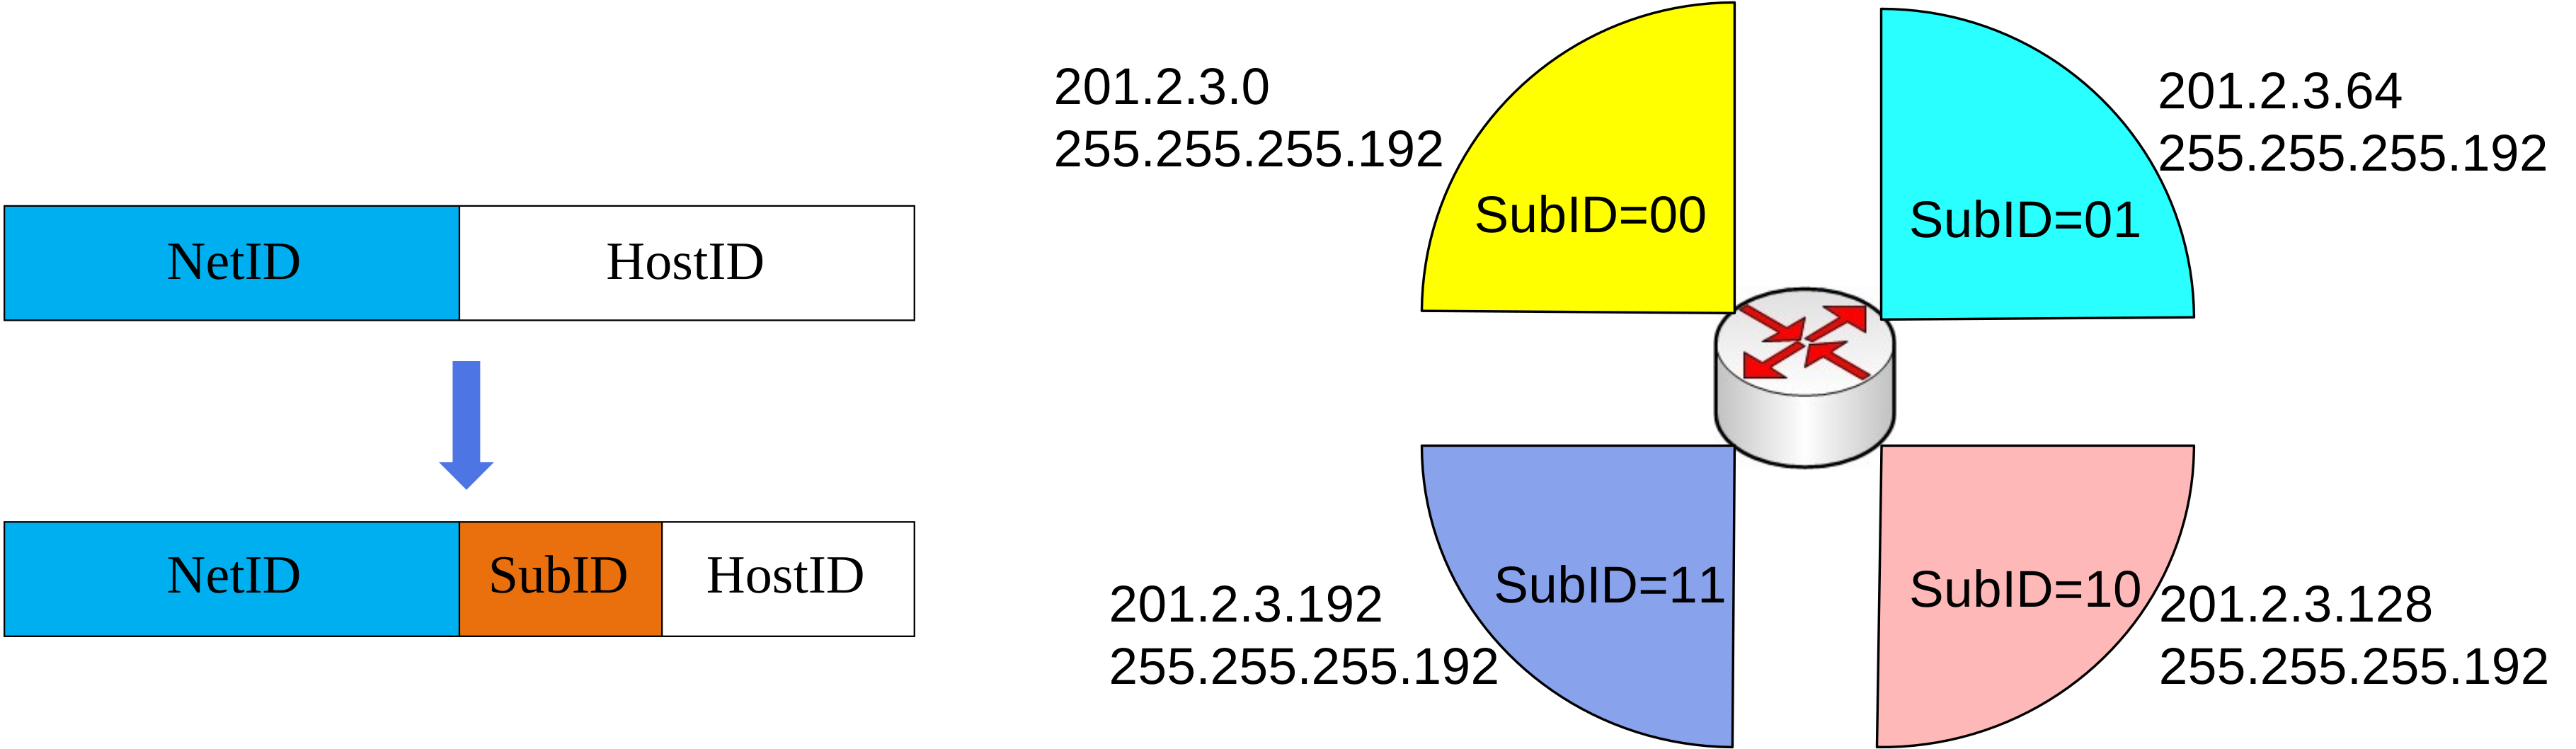
子网掩码:用来告诉机器,一个 IPv4,哪些 bit 属于 NetID+SubID,哪些属于主机号
- 形如 IP 地址
- NetID、SubID 位全取1
- HostID 位全取0
- 例如:
- A网的默认子网掩码为
255.0.0.0 - B网的默认子网掩码为
255.255.0.0 - C网的默认子网掩码为
255.255.255.0 - B网+借用3bit划分: 子网掩码
255.255.224.0
- A网的默认子网掩码为
举例,一个子网 201.2.3.0, 255.255.255.0 想要划分为4个等长的子网:(SubID 长度为2)
201.2.3.0, 255.255.255.192201.2.3.64, 255.255.255.192201.2.3.128, 255.255.255.192201.2.3.192, 255.255.255.192
如何计算子网地址:
- IP地址与子网掩码 按位与 运算
CIDR (无类域间路由,Classless InterDomain Routing)
- 消除传统的 A、B、C类地址的界限
NetID + SubID可以任意长度- 地址格式
a.b.c.d/x,其中 x 是前缀长度 - 优点:
- 提高空间地址分配效率
- 可以把多个子网聚合为较大的子网(超网,suppernetting)
- 层级结构使路由信息通告更高效
路由选择原则:最长前缀匹配优先
DHCP
一个主机如何获取 IP 地址?
- 硬编码:静态配置
- DHCP (动态主机配置协议,Dynamic Host Configuration Protocol)
- 从服务器动态获取: IP地址、子网掩码、默认网关地址、DNS服务器的名称和IP地址
- 即插即用
- 允许地址再次分配
- 支持在用地址续租
DHCP 协议通过报文实现
- 客户端广播 DHCP discover (发现报文)
src: 0.0.0.0:68(全0为未分配IP,68是 DHCP 协议的 Client 端口)dst: 255.255.255.255:67(全1表示广播,67是 DHCP 协议的 DHCP Server 端口)yiaddr: 0.0.0.0服务器准备/已经分配给客户端的IP地址,目前不清楚所以置0transaction ID: 654事务ID
- DHCP server 利用 DHCP offer (提供报文) 进行响应
src:223.1.2.5:67DHCP server 的地址dst: 255.255.255.255:68这次的报文也是通过广播发出的yiaddr: 223.1.2.4DHCP Server 愿意分配给客户端的 IPtransaction ID: 654lifetime: 3600 secs
- 客户端请求IP地址: DHCP request (请求报文)
- 可能有多个 DHCP server 给出 offer,主机选择一个
src: 0.0.0.0:68dst: 255.255.255.255:67为什么还是广播?让别的 DHCP server 快速收回预分配的资源yiaddr: 0.0.0.0Requested IP Address: 223.1.2.4我选择的 IPtransaction ID: 654lifetime: 3600 secs
- DHCP服务器分配IP地址: DHCP ack (确认报文)
src: 223.1.2.5:67dst: 255.255.255.255:68yiaddr: 223.1.2.4transaction ID: 654lifetime: 3600 secs
其它
- DHCP 在应用层实现
- 请求报文以 UDP 的协议封装
网络地址转换 NAT
原因
- 只能从 ISP 申请一个 IP 地址
- IPv4 地址耗尽
- 本地网络设备 IP 地址变更,不想通知外界
- 变更 ISP 时,不想修改内部设备的 IP地址
- 内部网络对外界往来不可见,外部不可直接寻址(安全)
实现
- 替换:
(local_IP, port)(LAN 端地址) 与(NAT_IP, new_port)(WAN 端地址)的映射关系,存储到 NAT转换表 中 - 有流量进入/外出时,做替换
评价
- 端口号是 16bit 字段,最多可以支持 65535 个并行连接
- NAT 的主要争议:
- 路由器应该只处理网络层,NAT 还改动了传输层的内容(端口号)
- 违背端到端通信原则,应用开发者还必须考虑 NAT 的存在(如 P2P应用)
- 地址短缺问题应该有 IPv6 来解决
NAT穿透问题:外部机器首次访问内部机器时,NAT 还没有建立映射,不知道转发给哪台机器
- 静态配置 NAT,例如配置
123.31.1.3:2500总是转发给10.0.0.1:25000 - UPnP(Universal Plug and Play,通用即插即用)互联网网关设备协议(IGD-Internet Gateway Device) 自动配置
- 中继(如 Skype):公共网络上设置中继服务器,外部机器和内部机器通过中继服务器连接
ICMP(互联网控制报文协议)
功能,使主机和服务器:
- 差错(或异常)报告
- 网络探询
两类 ICMP 报文
- 差错报告报文(5种)
- 目的不可达
- 源抑制(Source Quench),路由已满
- 超时/超期(TTL)
- 参数问题(转发时,发现某些参数有问题)
- 重定向 (Redirect),转发时发现不应当由自己转发,而应当由另一个路由器来转发
- 网络探询报文(2组)
- 回声(Echo)请求与应答报文(Reply)
- ping 命令
- 时间戳请求与应答报文
- 回声(Echo)请求与应答报文(Reply)
| 类型(Type) | 编码(Code) | description |
|---|---|---|
| 0 | 0 | 回声应答 (ping) |
| 3 | 0 | 目的网络不可达 |
| 3 | 1 | 目的主机不可达 |
| 3 | 2 | 目的协议不可达 |
| 3 | 3 | 目的端口不可达 |
| 3 | 6 | 目的网络未知 |
| 3 | 7 | 目的主机未知 |
| 4 | 0 | 源抑制(拥塞控制-未用) |
| 8 | 0 | 回声请求(ping) |
| 9 | 0 | 路由通告 |
| 10 | 0 | 路由发现 |
| 11 | 0 | TTL超期 |
| 12 | 0 | IP首部错误 |
几种不发送 ICMP差错报告报文的特殊情况:
- 对ICMP差错报告报文不再发送 ICMP差错报告报文
- 除第1个IP数据报分片外,对所有后续分片均不发送ICMP差错报告报文
- 对所有多播IP数据报均不发送 ICMP差错报告报文
- 对具有特殊地址(如127.0.0.0 或 0.0.0.0)的IP数据报不发送 ICMP 差错报告报文
几种 ICMP 报文已不再使用
- 信息请求与应答报文
- 子网掩码请求和应答报文
- 路由器询问和通告报文
ICMP 的一个应用:Traceroute
- 原理:发送一组 UDP 数据报,其 TTL 分别设置为 1, 2, 3, …
- 分析收到的 ICMP 报文
IPv6
原因
- IPv4 已经分配殆尽
- 改进首部格式、快速处理/转发数据报
- 支持 QoS
IPv6 datagram 格式
- 固定长度的40字节基本首部
- IPv6 路由器不允许分片
- 如果 MTU 超了,路由器丢弃,并发返回 ICMP,源主机减少分片大小
IPv6 的 datagram
- 优先级(priority)
- 流标签(flow Label):标识同一“流”中的数据报
- 下一个首部(next header): 标识下一个选项首部或上层协议首部(如TCP首部)
- 跳步限制:对应 IPv4 的 TTL
对比 IPv4 的变化
- 校验和(checksum): 彻底移除。(原先每一跳都要修改 TTL,因此每次都要重新计算 checksum)
- 选项(options): 允许,但是从基本首部移出,定义多个选项首部,通过“下一个首部”字段指示
- ICMPv6: 新版ICMP
- 增加报文类型,e.g. “Packet Too Big”
- 多播组管理功能(IPv6 不再有广播)
IPv6 地址的标识
- 本质:128bit
- 一般形式:8组4位16进制,例如:
1080:0:FF:0:8:800:200C:417A - 压缩形式:
FF01:0:0:0:0:0:0:43->FF01::43(连续冒号只能使用1次) - 兼容 IPv4:
0:0:0:0:0:FFFF:13.1.68.3或者::FFFF:13.1.68.3 - 地址前缀
2002:43c:476b::/48- IPv6 不再使用掩码
- URLs:为了防止歧义
http://[3FFE::1:800:200C:417A]:8000
IPv4 和 IPv6 共存技术:隧道技术
- IPv6数据报作为IPv4数据报的载荷进行封装,穿越IPv4网络,然后再卸载位 IPv6 数据包
IPv6 的通信类型
- 单播单播(unicast): 一对一通信
- 多播(multicast): 一对多通信。IPv6 没有 Broadcast
- 任意播(anycast):一对一组之一(最近一个)通信
路由算法
网络层核心的功能就是路由和转发,其依据是转发表,而转发表来自路由算法。
网络抽象:Graph(有向有权图)
- 节点:路由器
- 边:链路
- 权重:每个链路的 cost
- 可以说:全为 1、带宽的倒数、拥塞程度、流量费用等。
路由算法,就是寻找最小路径的算法
路由算法的分类:
- 静态路由 vs 动态路由?
- 静态路由:手工配置、更新慢、优先级高
- 动态路由:更新快、定期更新、及时响应链路费用或网络拓扑变化
- 全局信息 vs 分散信息?
- 全局信息:所有路由器掌握完整的网络拓扑和链路费用信息
- E.g. 链路状态(LS)路由算法
- 分散(decentralized)信息:
- 路由器只掌握物理相连的邻居以及链路费用
- 邻居间信息交换、运算的迭代过程
- E.g. 距离向量(DV)路由算法
- 全局信息:所有路由器掌握完整的网络拓扑和链路费用信息
Dijkstra 算法
- 所有节点掌握整体图信息
- 通过“链路状态广播”传递信息
- 所有节点拥有相同的信息
- 算法本身参考:数据结构
- 缺点:震荡 (oscillations)。如图,随着时间变化,最佳路线在
B -> C -> D -> A和D -> C -> B -> A之间震荡,导致数据报在节点之间震荡,直到 TTL 归零
Bellman-Ford算法
- 节点只需要知道邻居的信息,以及自己到邻居的 cost
- 要计算 x 到 y 的最短路径:
- $d(x, y) = \min\limits_{v} { c(x,v) + d_v(y) }$
- 其中, $d(x,y)$ 是 x 到 y 的最短距离(费用)
- $\min\limits_{v}$ 中的 $v$ 是 x 的所有邻居
- $c(x,v)$ 是 $x$ 到其邻居 $v$ 的距离
- $d(v,y)$ 是 邻居 $v$ 到 $y$ 的距离
评价
- 需要很多次迭代,才能趋近于最优值
- 异步迭代、分布式
- 每个节点x:
- 需要获得到每个邻居的距离 $c(x,v)$
- 还需要获得邻居的距离 $d(v,y)$
- 当节点获取邻居的 $d(v,y)$后,需要重新计算 $d(x,y)$
- 节点还需要定期把自身的 $d(x,y)$ 发送给所有邻居
缺点1:好消息传播快,坏消息传播慢,下面的例子说明,当 x -> y 距离从 4 变成 60 后,发生什么。时序:
- 初始:
d(y, x) = 4; d(z, x) = 5 - 一条边变慢:
c(y, x) = 4 -> 60 - 更新
d(y, x) = d(z, x) + c(y, z) = 4 + 1 = 5 - 更新
d(z, x) = d(y, x) + c(z, y) = 5 + 1 = 6 - 更新
d(y, x) = 7 - …
- 经历很多轮后,迭代结束
d(y, x) = 51; d(z, x) = 50
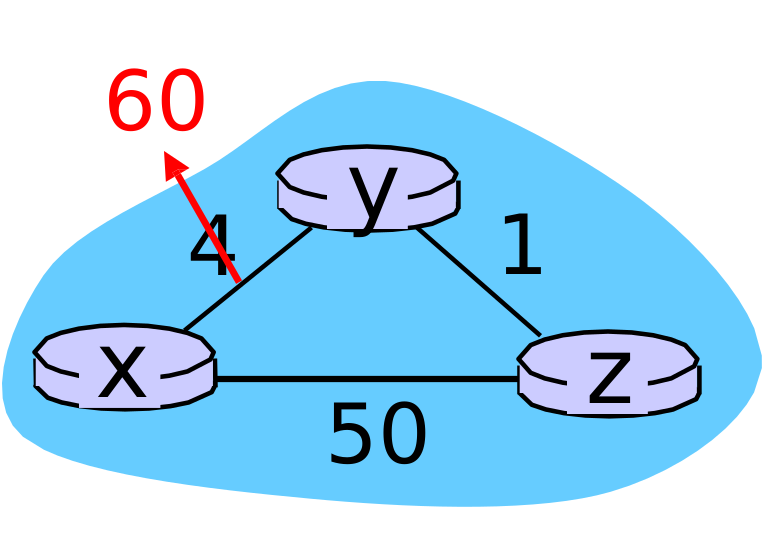
解决方案1:毒性逆转(poisoned reverse)。如果最小路径 $d(x, y)$ 是通过邻居 $z$ 实现的,那么 $x$ 把自己的距离信息通知给 $z$ 时,宣称 $d(x, y) = \inf$。使用此方案后的时序:
- 初始:
- y 节点:
d(y, x) = 4; d(z, x) = inf - z 节点:
d(z, x) = 5; d(y, x) = 4
- y 节点:
- 一条边变慢:
c(y, x) = 4 -> 60 - 更新
- y 节点:
d(y, x) = min(60 , inf + 1)= 60; d(z, x) = inf - z 节点:本次迭代不变
- y 节点:
- 更新:y 节点把上次迭代的结果通知 z 节点
- z 节点:
d(y, x) = 60; d(z, x) = min(60 + 1, 50) = 50
- z 节点:
- 更新: z 节点把上次迭代结果通知 y 节点
- y 节点:
d(y, x) = 60; d(z, x) = 50->d(y, x) = min(60, 50 + 1) = 51
- y 节点:
- 最终状态:
- y 节点:
d(y, x) = 51; d(z, x) = 50 - z 节点:
d(z, x) = 50; d(y, x) = inf
- y 节点:
解决方案2:定义最大度量(maximum metric)
- 定义一个最大 TTL,例如 16 跳后距离定为 inf
- 使其不会无穷次跳转/迭代
层次路由:一种有效的路由策略。 原因:将超大规模的网络抽象为一个图,其算法无法实现。
- 无法标识所有路由器,
- 路由表无法存储巨大的信息
- 链路状态互换,信息量巨大,回淹没整个网络
- 局部管理自治问题:每个子网希望自主控制路由
做法:
- 聚合路由器为一个区域:AS (autonomous systems,自治系统)
- 同一AS内的路由器运行相同的路由协议(算法)
- 自治系统内部路由协议(“intra-AS” routing protocol)
- 不同自治系统内的路由器可以运行不同的AS内部路由协议
- 网关路由器(gateway router):
- 位于AS“边缘”
- 通过链路连接其他AS的网关路由器
- 不同的 AS 之间也有协议:BGP(Border Gateway Protocol,边界网关协议)
- 热土豆路由 (Hot-Potato Routing)是一种策略:尽可能早地把数据包交给其他 AS,减少数据包在自己网络内部传输的距离和成本
- 名字来自“烫手的土豆”:拿到以后赶紧扔出去。
- 使用此策略,一个 AS 倾向于内部代价最小(或者说,运营商自己的成本最低)
Internet 采用层次路由,常见协议:
- 内部网络协议 (IGP,interior gateway protocols)
- 最常见的AS内部路由协议:
- 路由信息协议:RIP(Routing Information Protocol)
- 开放最短路径优先:OSPF(Open Shortest Path First)
- 内部网关路由协议:IGRP(Interior Gateway Routing Protocol)
- Cisco私有协议
RIP
- 度量 cost:用跳步数,每条链路 1 个跳步
- 最多跳步 max = 15(防止无穷计数问题)
- 每 30秒,邻居交换一次 DV,成为 通告(advertisement)
- 每次通告:最多 25个目的子网
- 如果 180秒没有收到通告:认为邻居(链路)失效
- 同样采用了 毒性逆转技术
- 是应用层进程实现的
- 通告是通过 UDP 数据报发送的
OSPF
- 开放:公众可用
- 算法:链路状态路由算法
- LS分组扩散(通告)
- 每个路由器构造完整的网络(AS)拓扑图
- 利用 Dijkstra算法 计算路由
- OSPF通告中每个入口对应一个邻居
- OSPF通告在整个AS范围泛洪
- OSPF报文直接封装到 IP数据报 中
- 与OSPF极其相似的一个路由协议: IS-IS路由协议
OSPF 是 RIP 的改进,它相对 RIP 有这些优点:
- 允许使用 多条 相同费用的路径 (RIP只能选一条)
- 对于每条链路,可以针对不同的 TOS 设置多个不同的费用度量 (e.g., 卫星链路可以针对“尽力” (best effort) ToS设置“低”费用;针对实时ToS设置“高”费用)
- 集成单播路由与多播路由:
- 多播OSPF协议(MOSPF) 与OSPF利用相同的网络拓扑数据
- OSPF支持对大规模AS分层(hierarchical)
第9周 网络层(下)(2h56m22s)
4.9 路由算法(1h43m13s)
4.10 Internet路由(1h13m09s)
数据链路层
第10周 数据链路层(1h59m14s)
5.1 数据链路层服务(15m08s)
5.2 差错编码(30m59s)
5.3 多路访问协议(1h13m07s)
第11周 局域网(2h30m58s)
5.4 ARP协议(28m53s)
5.5 以太网(1h03m56s)
5.6 PPP协议(20m11s)
5.7 802.11无线局域网(37m58s)
物理层
第12周 物理层(2h37m53s)
6.1 数据通信基础(37m29s)
6.2 物理介质(22m04s)
6.3 信道与信道容量(19m32s)
6.4 基带传输基础(29m22s)
6.5 频带传输基础(40m53s)
6.6 物理层接口规程(8m33s)
网络安全基础
第13周 网络安全基本原理(4h36m31s)
7.1 网络安全基础(35m24s)
7.2 网络安全威胁(32m55s)
7.3 密码学基础(2h07m16s)
7.4 身份认证(23m12s)
7.5 消息完整性与数字签名(36m47s)
7.6 密钥分发与公钥证书(20m57s)
第14周 网络安全协议与技术(4h14m48s)
8.1 安全电子邮件(39m54s)
8.2 安全socket层(SSL)(1h07m58s)
8.3 IP安全(IPsec)(1h31m06s)
8.4 无线局域网安全(31m18s)
8.5 防火墙(24m32s)
参考资料
- 李全龙 、聂兰顺:《计算机网络》课程,哈尔滨工业大学,中国大学MOOC https://www.icourse163.org/course/HIT-154005
- 本文的一些 素材
以太网帧 Ethernet Frame
┌─────────────────────────────────────────┐
│ 以太网首部                              │
│                                         │
│ IP 数据报                               │
│ ┌─────────────────────────────────────┐ │
│ │ IP 首部                             │ │
│ │ - 源 IP                            │ │
│ │ - 目的 IP                          │ │
│ │ - 协议号:TCP                      │ │
│ │                                     │ │
│ │ TCP 报文段                          │ │
│ │ ┌─────────────────────────────────┐ │ │
│ │ │ TCP 首部                        │ │ │
│ │ │ - 源端口                        │ │ │
│ │ │ - 目的端口                      │ │ │
│ │ │ - 序列号、确认号、标志位等      │ │ │
│ │ │                                 │ │ │
│ │ │ 应用层数据                      │ │ │
│ │ └─────────────────────────────────┘ │ │
│ └─────────────────────────────────────┘ │
└─────────────────────────────────────────┘
您的支持将鼓励我继续创作!