关注
🔥 数据结构
🗓 2017年05月18日 📁 文章归类: 0x10_计算机基础
版权声明:本文作者是郭飞。转载随意,标明原文链接即可。
原文链接:https://www.guofei.site/data_structure.html
目录
- 线性结构
- 数组。Array, 动态数组,
- 链表。单链表, 双向链表, 循环链表, 跳跃表
- Stack/Queue, Deque, 循环队列,
- 哈希
- HashTable, HashSet, HashMap
- 递归
- 查找
- 排序
- 简单排序:冒泡、选择、插入、希尔排序
- 分置排序:快速排序、归并排序
- 其他:堆排序、基数排序
- 树
- 图
- 动态规划
其他专题
其它基本算法
- DFS/BFS
- 递归
- 遍历(借助queue做BFS,借助stack做DFS)
- 二分法
- 排序
- 贪心
树
- 平衡树。插入、删除、搜索,O(ln n) ,且保持平衡树
- AA树:一种自平衡二叉树
图
- 最短路径算法
- A-star 算法,启发式
- Bellman-Ford 算法,适用于含负数权重的加权图 $O(n^3)$
- Dijkstra 算法,不含负数权重 $O(n^2)$
- 双向 Dijkstra 算法,减少后一半的搜索空间,因此比 Dijkstra 快一些
复杂度 的一些定义:
定义1
$O(g)$代表一组函数,
$f\in O(g) \Leftrightarrow$
$ \exists n_0 ,c $使得$\forall n \geq n_0 , f(n) \leq cg(n)$
定义2
$\Omega (g)$的定义恰恰相反
$ \exists n_0 ,c $使得$\forall n \geq n_0 , f(n) \geq cg(n)$
定义3
$\Theta(g)=O(g) \cap \Omega(g)$
递归中复杂度主定理
如果递归计算量是这样的:
$T(n)=aT(n/b)+f(n)$
那么,复杂度为:
$\Theta(n^{log_{b} a})$
线性结构
主要内容
- 顺序表
- 链表
- 单链表
- 单循环链表
- 双向循环链表
- 跳跃表
- 并查集
顺序表
顺序表是在内存中连续存放的数组。
顺序表有如下操作:
- 初始化
- 求元素个数
- 在i位置插入一个元素。从后往前,依次后移1格,直到i位置。
- 删除一个元素。类似的相反操作
因此,顺序表的增、删操作,时间复杂度都是 O(n)
单链表
有两种:
- 带头结点单链表(用一个空节点作为头部结点)
- 代码更简洁,因此这里统一使用这一种
- 不带头结点单链表(用第一个数据节点作为头部结点)
class Node(object):
    def __init__(self, val=None, next=None):
        self.val = val
        self.next = next

    def __repr__(self):
        return str(self.val)


# 带dummy的LinkedList
class MyLinkedList:
    def __init__(self):
        self.head = Node(val='□')  # 打印要用
        self.size = 0

    def get(self, index):
        assert 0 <= index < self.size
        curr = self.head
        for _ in range(index + 1):
            curr = curr.next
        return curr.val

    def add_at_tail(self, val):
        curr = self.head
        while curr.next:
            curr = curr.next
        curr.next = Node(val)
        self.size += 1

    def add_at_index(self, index, val):
        assert 0 <= index < self.size
        curr = self.head
        for i in range(index):
            curr = curr.next
        curr.next = Node(val=val, next=curr.next)
        self.size += 1

    def delete_at_index(self, index):
        assert 0 <= index < self.size
        curr = self.head
        for i in range(index):
            curr = curr.next
        curr.next = curr.next.next

        self.size -= 1

    def from_list(self, lst):
        curr = self.head
        for val in lst:
            curr.next = Node(val=val)
            curr = curr.next
            self.size += 1

    def to_list(self):
        curr = self.head.next
        res = list()
        while curr is not None:
            res.append(curr.val)
            curr = curr.next
        return res

    def __repr__(self):
        return ' -> '.join([self.head.val] + [str(i) for i in self.to_list()])


if __name__ == "__main__":
    my_linked_list = MyLinkedList()
    lst = [1, 1, 2, 3, 4, 5]
    my_linked_list.from_list(lst)
    assert my_linked_list.to_list() == lst
    print(my_linked_list)
刷题技巧
- 使用带dummy的链表,往往可以使代码更好写。LeetCode 给的格式都是不带头节点的,做个 next 即可
- 遇到多链表的时候,你可能需要
curr = curr.next if curr else curr,这样 curr 如果为 None,就表示它早已到达终点
侵入式链表:C语言使用,性能更高,但与业务耦合。
静态链表:用 list 来存储数据,以及 next index,用 C 或 Rust 这类语言写业务代码,这种实现是更为推荐的。
class MyLinkedList:
    def __init__(self):
        self.data = ['□']
        self.next_index = [-1]
        self.head = 0  # dummy
        self.tail = 0
        self.size = 0

    def get(self, index):
        """获取逻辑索引 index 处的值,O(n)"""
        assert 0 <= index < self.size

        curr = self.next_index[self.head]
        for _ in range(index):
            curr = self.next_index[curr]
        return self.data[curr]

    def add_at_tail(self, val):
        """尾部插入,O(1)"""
        idx = len(self.data)
        self.data.append(val)
        self.next_index.append(-1)

        self.next_index[self.tail] = idx
        self.tail = idx
        self.size += 1

    def add_at_index(self, index, val):
        """在逻辑索引 index 处插入,O(n)"""
        assert 0 <= index <= self.size

        if index == self.size:
            self.add_at_tail(val)
            return

        prev = self.head
        for _ in range(index):
            prev = self.next_index[prev]

        idx = len(self.data)
        self.data.append(val)
        self.next_index.append(self.next_index[prev])
        self.next_index[prev] = idx
        self.size += 1

    def delete_at_index(self, index):
        """删除逻辑索引 index 处的节点,O(n)"""
        assert 0 <= index < self.size

        prev = self.head
        for _ in range(index):
            prev = self.next_index[prev]

        curr = self.next_index[prev]
        self.next_index[prev] = self.next_index[curr]

        if curr == self.tail:
            self.tail = prev

        self.size -= 1

    def from_list(self, lst):
        """从 list 重建链表,O(n)"""
        self.data = ['□'] + lst.copy()
        self.next_index = list(range(1, len(self.data))) + [-1]
        self.head = 0
        self.tail = len(self.data) - 1
        self.size = len(lst)

    def to_list(self):
        """转为普通 Python list,O(n)"""
        res = []
        curr = self.next_index[self.head]

        while curr != -1:
            res.append(self.data[curr])
            curr = self.next_index[curr]

        return res

    def compact(self):
        """整理链表:重新排列节点,并清除已删除的节点,O(n)"""
        new_data = [self.data[self.head]]
        curr = self.next_index[self.head]

        while curr != -1:
            new_data.append(self.data[curr])
            curr = self.next_index[curr]

        self.data = new_data
        self.next_index = list(range(1, len(new_data))) + [-1]

        self.head = 0
        self.tail = len(new_data) - 1
        self.size = len(new_data) - 1

    def __repr__(self):
        return ' -> '.join(['□'] + [str(i) for i in self.to_list()])


if __name__ == "__main__":
    ll = MyLinkedList()
    ll.from_list([1, 1, 2, 3, 4, 5])

    assert ll.to_list() == [1, 1, 2, 3, 4, 5]
    assert ll.get(2) == 2

    ll.add_at_index(2, 10)
    assert ll.to_list() == [1, 1, 10, 2, 3, 4, 5]

    ll.delete_at_index(3)
    assert ll.to_list() == [1, 1, 10, 3, 4, 5]

    ll.add_at_tail(6)
    assert ll.to_list() == [1, 1, 10, 3, 4, 5, 6]

    print(ll)
    print(ll.data)
    print(ll.next_index)
一些经典算法
- Two pointers starts at different position: one starts at the beginning while another starts at the end;
- Two pointers are moved at different speed: one is faster while another one might be slower.
一个来自 LeetCode的案例 141. Linked List Cycle
# Definition for singly-linked list.
# class ListNode(object):
#     def __init__(self, x):
#         self.val = x
#         self.next = None

class Solution(object):
    def hasCycle(self, head):
        """
        :type head: ListNode
        :rtype: bool
        """
        if head is None:
            return False
        fast=head
        slow=head
        while True:
            if (fast is None) or (slow is None):
                return False
            if (fast.next is None) or (fast.next.next is None) or (slow.next is None):
                return False
            fast=fast.next.next
            slow=slow.next
            if fast is slow:
                return True
reverse 链表
def reverseList(self, head):
    if head is None:
        return None
    curr=head
    while curr.next:
        tmp=curr.next
        curr.next=curr.next.next
        tmp.next=head
        head=tmp
    return head
环形链表
其实现与单链表很相似,不过检查结束的条件是 curr.next == head
双向链表
跳跃表
为什么:
- 顺序表。查找如果可以用二分法,复杂度是 O(logn), 插入和删除都是 O(n)
- 链表不能用二分法,查找复杂度是O(n),插入、删除复杂度是 O(1)
- 二叉树,虽然插入、删除、查找也是 O(logn),但仅限于平衡二叉树,遇到严重偏到一边的二叉树,复杂度仍然是 O(n)
- 红黑树。本身实现很复杂,并且插入、删除时,同时做一次平衡,提高了一定的花销。
跳跃表是什么?
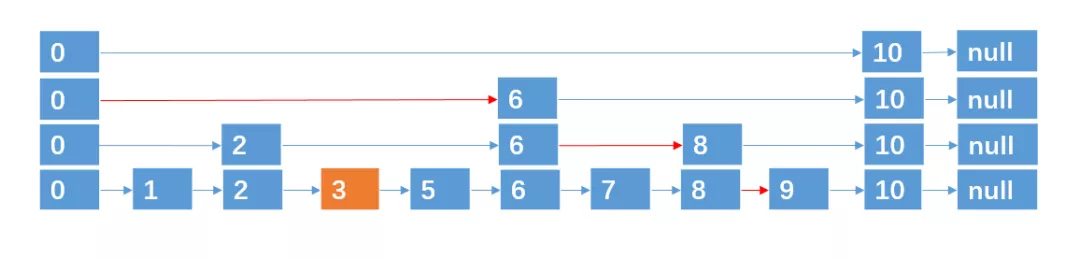
- 查找:这就可以用二分法了,复杂度 O(logn)
- 插入:抛硬币来决定新插入结点跨越的层数:每次我们要插入一个结点的时候,就来抛硬币,如果抛出来的是 正面,则继续抛,直到出现 负面 为止,统计这个过程中出现正面的 次数,这个次数作为结点跨越的层数。
- 删除:从每个链条删除即可
查找、插入、删除复杂度都是 O(logn)
总结下跳跃表的有关性质:
- 跳跃表的每一层都是一条有序的链表.
- 跳跃表的查找次数近似于层数,时间复杂度为O(logn),插入、删除也为 O(logn)。
- 最底层的链表包含所有元素。
- 跳跃表是一种随机化的数据结构(通过抛硬币来决定层数)。
- 跳跃表的空间复杂度为 O(n)。
矩阵
压缩存储:
- 对称矩阵,上/下三角矩阵:用线性表存一半,线性表的下标 k 和 (i,j) 可以互相计算
- 稀疏矩阵:
[[i,j,val],[...],...]可以使用链表来存- 转置非常方便
栈和队列
主要内容:
- Stack:一种 last-in-first-out (LIFO) 算法
- Queue:一种 first-in-first-out (FIFO) 算法
- Circular Queue:循环队列
- 优先队列:按优先度出列
- 多级反馈队列
栈和队列实际上是(前面介绍的)线性表的应用
- list 天然地适合做 Stack,尾部入,尾部出 性能都是 O(1)
- list 删除头部的元素是极为低效的,因此不能直接做 Queue. 解决方法是很简单,只要增加一个指向头部的指针即可。但需要定期 compaction
栈:用 list 实现栈
class Stack(list):
    def push(self, term):
        self.append(term)

    def pop(self):
        return self.pop()
队列:用 deque 实现
from collections import deque

class Queue(object):
    def __init__(self):
        self.q = deque()

    def enqueue(self, term):
        self.q.append(term)

    def dequeue(self):
        return self.q.popleft()
队列:C实现:
- 链表
- 两个 stack 可以构造一个 queue:https://leetcode.cn/problems/implement-stack-using-queues/
- 循环array可以构造一个 queue:https://github.com/guofei9987/c-algorithm/tree/master/DynamicArray
队列实现
- Queue:借用 deque(底层是C实现的双端队列,多个数组片段组成的链表),是效率最高的了
- Queue1:用 list 实现队列
- Queue2:用链表
- Queue3: 用两个 stack 可以模拟一个 queue,效率仅比 deque 慢一点点
# 实现1: 用 list 实现队列(head_idx 指向头部)
class Queue1(object):
    def __init__(self):
        self._data = list()
        self._head_idx = 0

    def enqueue(self, term):
        self._data.append(term)

    def dequeue(self):
        if self._head_idx >= len(self._data):
            return None

        term = self._data[self._head_idx]

        self._data[self._head_idx] = None
        self._head_idx += 1
        return term

    def compact(self):
        # 定期压缩,否则内存会一直增加
        self._data = self._data[self._head_idx:]
        self._head_idx = 0


# 实现2:用链表
class Node(object):
    def __init__(self, val):
        self.val = val
        self.next = None


class Queue2(object):
    def __init__(self):
        self.head = Node(None)
        self.tail = self.head

    def enqueue(self, term):
        node_new = Node(term)
        self.tail.next = node_new
        self.tail = node_new

    def dequeue(self):
        if self.head is self.tail:
            raise None

        node_to_dequeue = self.head.next
        self.head.next = node_to_dequeue.next

        if node_to_dequeue is self.tail:
            self.tail = self.head

        return node_to_dequeue.val


# 实现3: 双 stack 可以实现一个 queue
class Queue3:
    def __init__(self):
        self.stack1 = list()
        self.stack2 = list()

    def enqueue(self, val):
        self.stack1.append(val)

    def dequeue(self):
        if not self.stack2:
            self.stack2 = self.stack1[::-1]
            self.stack1 = list()
        return self.stack2.pop()
循环队列 Circular Queue
可以用list来模拟Cirular Queue
num_list[i%len_list]
优先队列 这样的队列:每个项目对应一个优先度,出列顺序按照优先度来排。
- 常用于计算机进程分配、医院急救队列
- 一般用二叉堆来实现,二叉堆见于另一篇文章。
线性结构的应用
案例1:queue的一种典型应用场景是Breadth-first Search (BFS)
queue 案例2
题目灵感来自LeetCode题目,我给出的解答见于这里
例子:
input_queue=[1,2,3,4,5]
stack=[2,1]
pointer=0
for i in input_queue:
    stack.append(i)
    # 后两行是先出的功能:
    stack_out=stack[pointer]
    pointer+=1

# 事实上,因为可以使用stack[-1],stack[-2]这些命令,所以 pointer 这个变量往往不必定义
# 会有内存浪费,定期清理即可,参考代码: stack=stack[pointer:]
案例3:深度优先搜索 Depth-First Search (DFS)
哈希
- 哈希函数
- 数据中的关键字映射到存放位置的映射函数叫做 哈希函数 。
- 哈希冲突
- $K_i,K_j(i\neq j)$是两个关键字。 把$K_i \neq K_j$,并且$h(K_i)=h(K_j)$现象叫做哈希冲突这样的$K_i,K_j$叫做 同义词
哈希冲突的可能性与三个因素有关:
- 填装因子$\alpha$。设已存入数据个数为n,哈希地址空间大小m,$\alpha=\dfrac{n}{m}$
- 哈希函数。如果选择得当,可以使哈希地址尽可能均匀分布在地址空间上。
- 哈希冲突函数:为解决
哈希冲突问题,有哈希冲突函数,哈希冲突函数的选取也影响哈希冲突的可能性
几个经典哈希函数
余数法
- 算法:关键字K,哈希表长度为m,那么:$h(K)=K \mod m$
- 优点:
- 算法简单,适用范围广
- 如果关键字均匀,那么映射到每个地址的概率也均匀,减少了哈希冲突的概率
直接定址法
- 算法:关键字K加上某个常量C,$h(K)=K+C$
- 特点:
- 优点:
- 计算简单
- 不可能有哈希冲突
- 缺点:
- 如果有1~1000的7个数字需要存放,可能需要1000个内存单元,造成大量浪费
- 优点:
数值分析法
- 分析数据内容,找出比较均匀的位(可以是多个),组合成为哈希地址
- 例如,某组数据有1000个数字,这些数字第1,3,6位取值比较均匀,那么可以提取1,3,6位,组成一个三位数作为哈希地址
哈希冲突的解决方法
有两个思路
- 链表法
- 开放定址法
链表法
- 如果哈希地址空闲,直接存放该数据。
- 如果哈希地址已被占用,把哈希冲突的数据放到链表中
开放定址法
- 如果没发生哈希冲突,直接存放该数据
- 如果发生了哈希冲突,把冲突的数据放入到别的 空闲单元 中
一些相关概念:
- 非同义关键字:把某个发生哈希冲突的数据放到另一个空闲单元d中,因为对应的关键字的哈希值不为d,就称为非同义关键字
- 开放定址法中,哈希空闲单元既向 同义关键字 开放,又向 非同义关键字开放,至于填入哪个,要看谁先占用它
- 非同义词冲突 在解决哈希冲突时,如果$K_i \neq K_j(i\neq j), h(K_i) \neq h(K_j)$, 但哈希冲突函数$h_1(K_i) = h_2(K_j)$,这种现象叫做非同义词冲突
开放定址法,在d位置发生哈希冲突时,探查下一个地址,这有几种探查策略:
- 线性探查法 \(\left \{ \begin{array}{lcl}
d_0=h(K)\\
d_i=(d_{i-1}+1)\mod m
\end{array}\right.\)
- 缺点是容易产生堆积问题,如果连续出现几个同义词后,将连续占用哈希表的内存单元
-
平方探查法 \(\left \{ \begin{array}{lcl} d_0=h(K)\\ d_i=(d_{i-1}+2^{i-1})\mod m \end{array}\right.\)
- 伪随机数法 \(\left \{ \begin{array}{lcl}
d_0=h(K)\\
d_i=(d_{i-1}+R)\mod m
\end{array}\right.\)
- 其中,R是一个伪随机数
递归
查找
二分法
我总结的一般写法
class Solution:
    def search(self, nums, target):
        # step1:定义初始搜索范围
        left,right=0,len(nums)-1
        if left==right:return None # step1.1 增加鲁棒性,也就是一开始即达到结束条件。需不需要视 step4是否容易写而定
        # step2:定义结束时的搜索范围,一般为left==right,但某些问题未必
        while left<right:
            mid=(left+right)//2
            if nums[mid]<target: # step2.5:必须把所有的if考虑到,否则有可能死循环
                left=mid+1
            elif nums[mid]>target:
                right=mid-1
            elif nums[mid]==target: # step3:搜索时遇到解,便直接返回。如果是复杂形式,注意index out of range
                return mid
        # step4:搜索结束后的小区域的情况判断。这里小区域范围为1,且必为解,因此无需多做处理。
        # 一般情况下,应当处理这个小区域
        mid=left # 为了可读性(代码表示的统一性)。注意决不能直接使用之前的mid,因为那个赋值是否运行是不一定的
        # if nums[left]==target: # 一般情况下,与while循环中的return出口条件一致
        #     return mid
        # else:return -1
        return -1
注:
- 某些题目中,可能搜索不到,让输出四舍五入解。最后一步的left可能越过“有理数解”,所以需要检查left-1
- 理论上right也可能越过,(不过如果要求输出舍弃小数,其实不用检查的)
LeetCode上的写法-第一种
def binarySearch(nums, target):
    """
    :type nums: List[int]
    :type target: int
    :rtype: int
    """
    if len(nums) == 0:
        return -1

    left, right = 0, len(nums) - 1
    while left <= right:
        mid = (left + right) // 2
        if nums[mid] == target:
            return mid
        elif nums[mid] < target:
            left = mid + 1
        else:
            right = mid - 1

    # End Condition: left > right
    return -1
- Initial Condition:
left = 0, right = length-1 - Termination:
left > right - Searching Left:
right = mid-1 - Searching Right:
left = mid+1
LeetCode上的写法-第二种
- Initial Condition:
left = 0, right = length - Termination:
left == right - Searching Left:
right = mid - Searching Right:
left = mid+1
LeetCode上的写法-第三种
- Initial Condition:
left = 0, right = length-1 - Termination:
left + 1 == right - Searching Left:
right = mid - Searching Right:
left = mid
并查集
是什么?
- 若干个集合,不断发生合并,要查询“两个元素是否在同一个集合中”
- 例如:无向图,快速判断任意两个节点之间是否连通。如果这个无向图不断新生成连接,仍能快速判断。
- 思路:
- 每个集合建立一个树,用根节点来代表这个集合
- 那么集合的合并相当于树的合并
- 查询“两个元素是否在同一个集合中”相当于查询“两个节点是否有共同的根节点”
class UnionFind:
    def __init__(self, n: int):
        self.component_count = n  # 集合的个数
        self.parent = list(range(n))
        self.size = [1] * n  # 每个集合大小,仅根结点处有效

    def find(self, x: int) -> int:
        if self.parent[x] != x:
            self.parent[x] = self.find(self.parent[x])
        return self.parent[x]

    def union(self, x: int, y: int) -> bool:
        """两个元素(连同所在的集合)连接到同一个集合"""
        root_x = self.find(x)
        root_y = self.find(y)

        if root_x == root_y:
            # x,y 原本就是同一集合
            return False

        # 按集合大小合并:小集合的根挂到大集合的根上
        if self.size[root_x] < self.size[root_y]:
            root_x, root_y = root_y, root_x

        self.parent[root_y] = root_x
        self.size[root_x] += self.size[root_y]
        self.component_count -= 1
        return True

    def is_connected(self, x: int, y: int) -> bool:
        """两个元素是否在同一个集合中"""
        return self.find(x) == self.find(y)

    def component_size(self, x: int) -> int:
        """返回元素 x 所在集合的元素数量"""
        return self.size[self.find(x)]
测试代码:
uf = UnionFind(6)  # 初始有 6 个集合:{0}, {1}, {2}, {3}, {4}, {5}

assert uf.component_count == 6

assert uf.union(0, 1) is True
assert uf.union(1, 2) is True
assert uf.union(3, 4) is True

assert uf.is_connected(0, 2) is True
assert uf.is_connected(0, 3) is False
assert uf.component_count == 3  # {0,1,2}, {3,4}, {5}

assert uf.union(0, 2) is False  # 重复合并
assert uf.component_count == 3

assert uf.union(2, 4) is True
assert uf.component_count == 2  # {0,1,2,3,4}, {5}
assert uf.component_size(0) == 5
assert uf.component_size(2) == 5
assert uf.component_size(4) == 5
assert uf.component_size(5) == 1

assert uf.union(0, 5) is True
assert uf.component_count == 1
assert uf.component_size(0) == 6

print("所有测试通过!")
- 对查询做了优化,做find的时候,自动把节点连接到根结点,
- 元素是 list(range(n)) 的int类型
- parent 是什么?
- parent[idx] 是 idx 的上一级,
- 如果被 find 过, parent[idx] 是根节点。否则的话是父节点,因此不能直接
len(set(parent))来判断有几个类 i == parent[i]用来判断 i 是否是根结点。(进而计算有几个类)
布隆过滤器
布隆过滤器(Bloom Filter) 是一种用极少空间判断“某个元素是否可能存在”的数据结构。
- 如果它返回“存在”,不一定存在
- 如果它返回“不存在”,一定不存在
典型使用场景:你有十亿个黑名单 URL,你需要快速过滤这些 URL
- 先用布隆过滤器,过滤掉非黑的 URL
- 然后访问昂贵资源
算法
- 组件
- 一个长度为 m 的 bit 树组,初始化为 0
- k 个 Hash 函数,这些 Hash 函数的值域为
[0, m-1]
- 插入
key1- 遍历计算
hash_1(key1), hash_2(key1), ..., hash_k(key1), 假设其值为v1, v2, ... - 分别令
bits[v1] = 1,bits[v2] = 1, …
- 遍历计算
- 不支持删除
- 查询
key2- 计算 hash 值
- 如果其对应的
bits[v]都是1,则“可能存在”,否则“必然不存在”
Python 实现
import hashlib


class BloomFilter:
    def __init__(self, size=1000, hash_count=3):
        """
        size: bit 数组长度
        hash_count: 哈希函数数量
        """
        self.size = size
        self.hash_count = hash_count
        self.bit_array = [0] * size

    def _hashes(self, item: bytes):
        """
        为同一个 item 生成 hash_count 个哈希位置
        """

        for i in range(self.hash_count):
            data = item + str(i).encode("utf-8")
            digest = hashlib.md5(data).hexdigest()
            index = int(digest, 16) % self.size
            yield index

    def add(self, item):
        """
        插入元素
        """
        for index in self._hashes(item):
            self.bit_array[index] = 1

    def __contains__(self, item: bytes):
        """
        判断元素是否可能存在
        """
        return all(self.bit_array[index] == 1 for index in self._hashes(item))


if __name__ == "__main__":
    bf = BloomFilter(size=100, hash_count=3)

    data = ["apple", "banana", "orange"]

    for x in data:
        bf.add(x.encode("utf-8"))

    test_items = ["apple", "banana", "grape", "watermelon"]

    for x in test_items:
        if x.encode("utf-8") in bf:
            print(f"{x}: 可能存在")
        else:
            print(f"{x}: 一定不存在")
计算假阴性概率
设位数组有 $m$ 位,插入 $n$)$ 个不同元素,哈希函数有 $k$ 个。假设哈希结果均匀、独立,假阴性概率为:
$p_{\mathrm{FP}} \approx \left(1-e^{-kn/m}\right)^k $
最优的 $k \approx (m/n)\ln 2$,然后取整
因此假阴性概率只与 $m/n$ 有关
| m/n | k(取整) | 假阳性概率 |
|---|---|---|
| 9.6 | 7 | 1% |
| 14.4 | 10 | 0.1% |
| 19.2 | 13 | 0.01% |
Count-Min Sketch
问题:有海量的元素,给定某个元素 a,如何知道其大概出现了多少次?
思路:(类似 布隆过滤器)
- 构建阶段。维护一个 m 长度的
list[int],每次做 k 个 Hash,这 k 个数对应list[int]的 index 所在的值 +1 - 查询阶段。k 个 Hash 对应的所有 int 中,最小的
评价:可能高估(Hash 冲突),但不可能低估
HyperLogLog
问题:给定一批元素,估算其不同元素的数量。使用 HaseSet 成本过大。
思路:
- 对元素做均匀 Hash,得到随机二进制串。其开头连续 0 的个数为 r,对应的概率为 $2^{-r}$
- 因此想到,遍历,并计算最大的连续 0 个数 r,元素个数就接近 $2^r$
- 然而,只用一个数据,随机波动太大,考虑分桶
- 前n位决定属于哪个桶
- 从 n+1 位开始计算前n个0
101 | 000101...
 ↑       ↑
桶 5    前导零 3
误差约为 1.04/sqrt(m)
bitSet
用一串二进制表示有限整数集合
- 占用空间小,每个元素只有1个字节
- 集合运算十分高效,因为都是位运算
- 并集:
A | B - 交集:
A & B - 对称差:按位异或
- 差集:
A & (~B)
- 并集:
Reservoir Sampling
有长度未知、无法全部放入内存的数据流,希望:均匀随机抽取 k 个元素
算法:
- 把前k个元素放入结果
reservoir = [x₁, x₂, ..., xₖ] - 取第i个元素,随机生成
j = randint(0,i) - 如果
j < k则reservoir[j] = x_i
排序
- 简单排序:冒泡、选择、插入、希尔排序
- 分置排序:快速排序、归并排序
- 其他:堆排序、基数排序
树
知识点
- 二叉树:以及各种遍历算法
- 哈夫曼树与编码
- AVL树
- B树与B+树
- 前缀树
- 红黑树
- 线段树
树的相关定义
【定义】树:一个连通且无回路的无向图称为树。一个无回路的无向图称为森林。
假设T是一个有n个节点的无向图,那么以下6个命题等价
- T是一个树
- T是无环图,且有n-1个边
- T是连通图,且有n-1个边
- 任意两个节点之间有且只有一条路径
- T是无环图,且任意添加一条边都会产生环路
- T是连通图,但任意删除一条边都会把T变成两个连通分量
【定义】生成树 连通无向图G的生成树T是这么定义的:
$G=(V,E), T=(V,E_1), E_1 \subseteq E$ 且 $T$ 是树
(当然,如果G不是连通图,那么也不存在生成树)
【定理】 连通图至少有一个生成树。
【定义】最小生成树 T是G的生成树,如果G是加权图,$w(T)=\sum\limits_{e\in E_1} w(e)$,那么,使得$w(T)$最小的T,叫做最小生成树
- 应用:如何用最少的光纤连接所有机房?
根节点:没有父节点的点
节点的度:某个节点拥有子节点的个数
叶节点:度为0的节点
分支节点:度不为0的节点
子节点
父节点
兄弟节点:共享同一个父节点的节点
树的度:所有节点的度的最大值
节点的层次:从根节点到某节点路径上的分支数,根节点的层次是0, 任意节点的层次=父节点的层次+1
树的深度:所有节点的层次的最大值。空树的深度是-1,只有一个根节点的树的深度是0
无序树:兄弟节点是无序的
有序树:兄弟节点是有序的。二叉树是一种有序树。
森林:m($m\geq 0$)颗树的集合叫做森林。一棵树的根节点有m颗子树,那么删掉根节点后,就变成包含m颗树的森林
对树进行删除、插入、搜索操作,最坏情况下复杂度为$\Theta(\lg n)$
Tree的表示
方法1 用结构化数据存 Tree
1、父节点表示法
- 优点:寻找父节点方便
- 缺点:寻找子节点不方便
| 点 | 父节点 |
|---|---|
| 0 | -1 |
| 1 | 0 |
| 2 | 0 |
| 3 | 1 |
| … | … |
2、子节点表示法
- 子节点这个字段可以是一个 array
- 子节点这个字段也可以是展开后的单个 node
| 点 | 子节点 |
|---|---|
2.2、针对二叉树:
| 点 | 左子节点 | 右子节点 |
|---|---|---|
3、 父子节点表示法:既有父节点,又有子节点
4、 子兄弟表示法:既有子节点,也有兄弟节点
方法2:链式存储
用指针指向子节点,大多数实现都是这种,见于代码。
方法3: 用 Array 存储 (仅限于二叉树)
(见于二叉树)
二叉树
二叉树的定义
- 二叉树是一种
有序树,由一个根节点和两个互不相交的子二叉树构成,两个自子二叉树分别叫做左子树和右子树 - 满二叉树 :一颗二叉树上,所有分支节点都存在左子树和右子树,并且所有叶子节点都在同一层。深度d的二叉有 $2^d-1$ 个节点
- 完全二叉树:满二叉树去掉末尾k个节点
二叉树的性质
- 第i层上最多有$2^i$个节点
- 深度为k的二叉树,最多有$2^{k+1}-1$个节点
- 一个完全二叉树有n个节点,那么深度$k=\log_2(n+1)-1$
- 一个二叉树,度为0,1,2的节点数为$n_0,n_1,n_2$, 那么, $n_0=n_2+1$
- 一个具有n个节点的完全二叉树,如果从上至下和从左至右从0开始编号那么,对于序号为i个节点,有:
- 如果i>0,双亲节点序号是 (i-1)//2; 如果i=0,那么i是根节点,无双亲节点
- 如果2i+1<n,那么左子节点序号为2i+1; 如果2i+1>=n, 那么无左子节点
- 如果2i+2<n,那么右子节点序号是2i+2; 如果2i+2>=n, 那么无右子节点
二叉树的存储,与上面的树的存储一致
一、结构化存储,维护这样的表
| data | leftChild | rightChild |
|---|---|---|
| 0 | 1 | 2 |
| 1 | 3 | -1(表示指向空指针) |
| … | … | … |
二、链式存储
class TreeNode:
    def __init__(self, val=0, left=None, right=None):
        self.val, self.left, self.right = val, left, right

    def __repr__(self):
        return 'Node val = {}'.format(str(self.val))
left 和 right 都是指针,指向下一个节点
三、顺序存储
用一个 list 存放二叉树的每一个结点(heapq 就是以这种方式存储二叉树的)
- 稀疏型顺序存储:二叉树的空节点也占一个位置,空节点的两个孩子(虽然实际不存在)也各自占一个位置
- 所以顺序表的第i个元素,其孩子节点序号必是 2 * i + 1, 2 * i + 2
- 紧凑型顺序存储:空节点占一个位置,但空节点的孩子不再占位置.
- 优点是节省空间,尤其是有很多空节点的二叉树。
其本质上是BFS(Level order)的结果
二叉树遍历
规定 D,L,R 分别代表“访问根节点”,“访问根节点的左子树”,“访问根节点的右子树”,这样便有6中遍历方式:
LDR,DLR,LRD,RDL,DRL,RLD
因为先遍历左子树和先遍历右子树的算法很相似,所以研究这几种遍历方式:
前序遍历(DLR),中序遍历(LDR),后序遍历(LRD)
给定一个遍历序列并不能唯一决定一个二叉树,但给定一个二叉树序列的前序遍历序列和一个中序遍历序列,可以唯一确定一个二叉树。
Huffman 树
为什么需要 Huffman 树
- 例子1。你是急救中心的接线员,当你接到一个电话时,你希望快速弄清楚患者的情况。
- 算法1:把所有的问题问一遍( 遍历 )算法复杂度为$O(n)$
- 算法2:要尽可能减少问题,使用 二叉树 算法复杂度为$O(\log n)$
- 算法3: 哈夫曼算法
- 平衡二叉树有效的前提之一,是发生概率均匀。
- 然而,我们必须做到快速识别(如“病人是否有呼吸”)
- 例子2. 压缩领域,每个字符出现的概率是不一样的。根据概率把不同的字符赋予不同的长度,可以实现文本长度最小化。
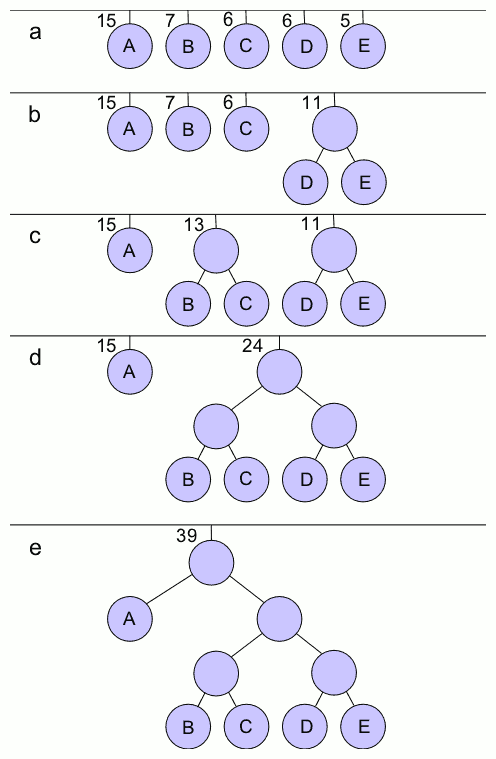
构建 Huffman 树实际上是这个问题:把“带权重的二叉树”路径之和最小化。哈夫曼算法是一种贪心算法。
huffman算法的Python实现
from heapq import heapify, heappush, heappop
from itertools import count


def huffman(seq, frq):
    num = count()
    trees = list(zip(frq, num, seq))
    heapify(trees)
    while len(trees) > 1:
        fa, _, a = heappop(trees)
        fb, _, b = heappop(trees)
        n = next(num)
        heappush(trees, (fa + fb, n, [a, b]))
    return trees[0][-1]

###下面是调用huffman算法:
seq = 'abcdefghi'
frq = [4, 5, 6, 9, 11, 12, 15, 16, 20]
print(huffman(seq, frq))
print(huffman(seq, frq)[0][-1])
因为反复选取、合并无序表项的复杂度是平方级,所以用heapq减少了复杂度到对数级
B树

每个节点这样设计的:

B树 非常适合用来文件索引、数据库索引,为什么呢?
- 如果只计算查找效率(即比较次数)的话,二叉树是最快的
- 但是,文件索引是存放在磁盘上的,而磁盘的寻址加载是以“页”为单位的,这时 B 树性能就更高了(寻址次数更少)
B 树相当于是一棵多叉查找树,对于一棵 m 阶的 B 树具有如下特性:
- 每个内部节点最多有 m个孩子,最多有 m-1个key
- 叶子节点没有孩子,最多有 m-1 个 key
- 每个内部节点至少有
ceil(m/2)个孩子,至少有ceil(m/2)-1个 key。这是为了至少半满,控制树高- 根节点例外:至少有2个孩子
- 所有的叶子节点都位于同一层。(B树是严格平衡的)
- 每个内部节点中的元素从小到大排列,节点当中的 k - 1 个元素正好是 k 个孩子包含的元素的值域划分。
- 每个节点(内部节点、叶子节点)的每个记录都是完整的数据条。区别于 B+树,B+树的内部节点仅存放 key
节点的查找 例如,要查找 55,用二分查找/遍历查找,发现 55 在 40 和 60 之间,然后进入对应的子节点,继续查找
节点的插入
假设是 3阶的 B树,

B 树适合磁盘寻址的原因:内存加载是整片加载进来的,就比一个一个从磁盘读进来要快。
如果内存不足以一次把整个树加载进来,用B树很合适,每次加载一个节点。因此如果在内存中,红黑树效率更高。如果涉及磁盘操作,B树效率更高。
B+树
B+树在B树的基础上做了改造,
- 内部节点只存索引 key
- 所有数据都存放在叶子节点。
- 因此,叶子节点本身就构成了完整的数据。
- 叶子结点之间还加了指针作为链表。

B+树的优势
- 磁盘整块读取,性能优势。这是最大的优势。
- 不过即使全部放入内存,还是有其它优势的:
- 即使全量读入内存,由于 cache/L1/L2/L3 的存在,其局部性的优势也仍然存在
- 保持内存/磁盘数据结构一致,不需要维护“内存态”和“磁盘态”两套索引
- (对比B树)树更矮。内部节点不存完整数据,只存 key 和 page 指针,因此一个节点能容纳更多 key
- 范围查询。数据库查询经常要处理类似 "BETWEEN xxx AND xxx" 这种范围查询,十分适配 B+树。因为是链表结构,所以只需要找到头和尾,然后用链表取出即可。
- 用 B树需要做局部中序遍历
- 用别的数据结构性能也不如 B+树
- 查询性能更稳定。B+ 树所有数据都在叶子节点,查询路径长度基本一致
插入和删除:都伴随节点的分裂与合并,使每个索引块指针利用率都在 50%-100% 之间
插入
- 如果插入后,节点没满,则结束。否则需要插入后分裂
- 分裂可能引发连锁反应,向上递归式分裂
- 如果根节点也满了,向上新建根节点(整个树的高度+1)
- 每次调整,都要同步调整指针


删除
- 如果删除后,节点还保持半满,则结束。否则触发借入或合并
- 从邻居借一个节点。如果不能借(借完少于一半了),就合并
- 向左/向右都可以
- 可以证明,如果不够借,那么一定可以合并。
- 每次调整,都要同步调整指针


对比其他的数据结构
Hash 索引 在同时满足这些条件时,更优(并且更新算法更简单):
- 数据全部在内存
- 只做等值查询
- 不做范围扫描
- 不做排序
- Sorted Array 数据只读,大量范围查询
- Trie 大量字符串 key,纯内存
BST、AVL、红黑树
BST 二叉搜索树
AVL(平衡二叉树) 的特性:
- 是一个二叉查找树
- 每个节点的左子树和右子树的高度差至多等于1。
用途:BST(二叉查找树)的查找操作是非常快的,但有个缺点:可能“不小心”构建了一个不平衡的二叉树,最差的情况就是变成个链表。所以我们需要 平衡二叉树 (AVL)
每次插入操作,需要做“左旋”或“右旋”来保持平衡二叉树
- 左左型:右旋
- 右右型:左旋
- 左右型:先左旋,后右旋
- 右左型:先右旋,后左旋
红黑树 为什么需要?
平衡二叉树虽然解决了二叉树退化到链表的缺点,能够把查找时间控制在 logn,但每次插入/删除节点时,都需要左旋/右旋来平衡二叉树。
是什么?红黑树有以下特点
- 是一个二叉查找树
- 根节点是黑的
- 叶子节点都是黑的空节点
- 任何相邻节点不能同时为红色
- 对每个节点,其到达任意可达的叶子结点的路径上,黑色节点数目都是相同的
红黑树实际上是不太严格的平衡树,插入/删除不需要频繁调整。
trie
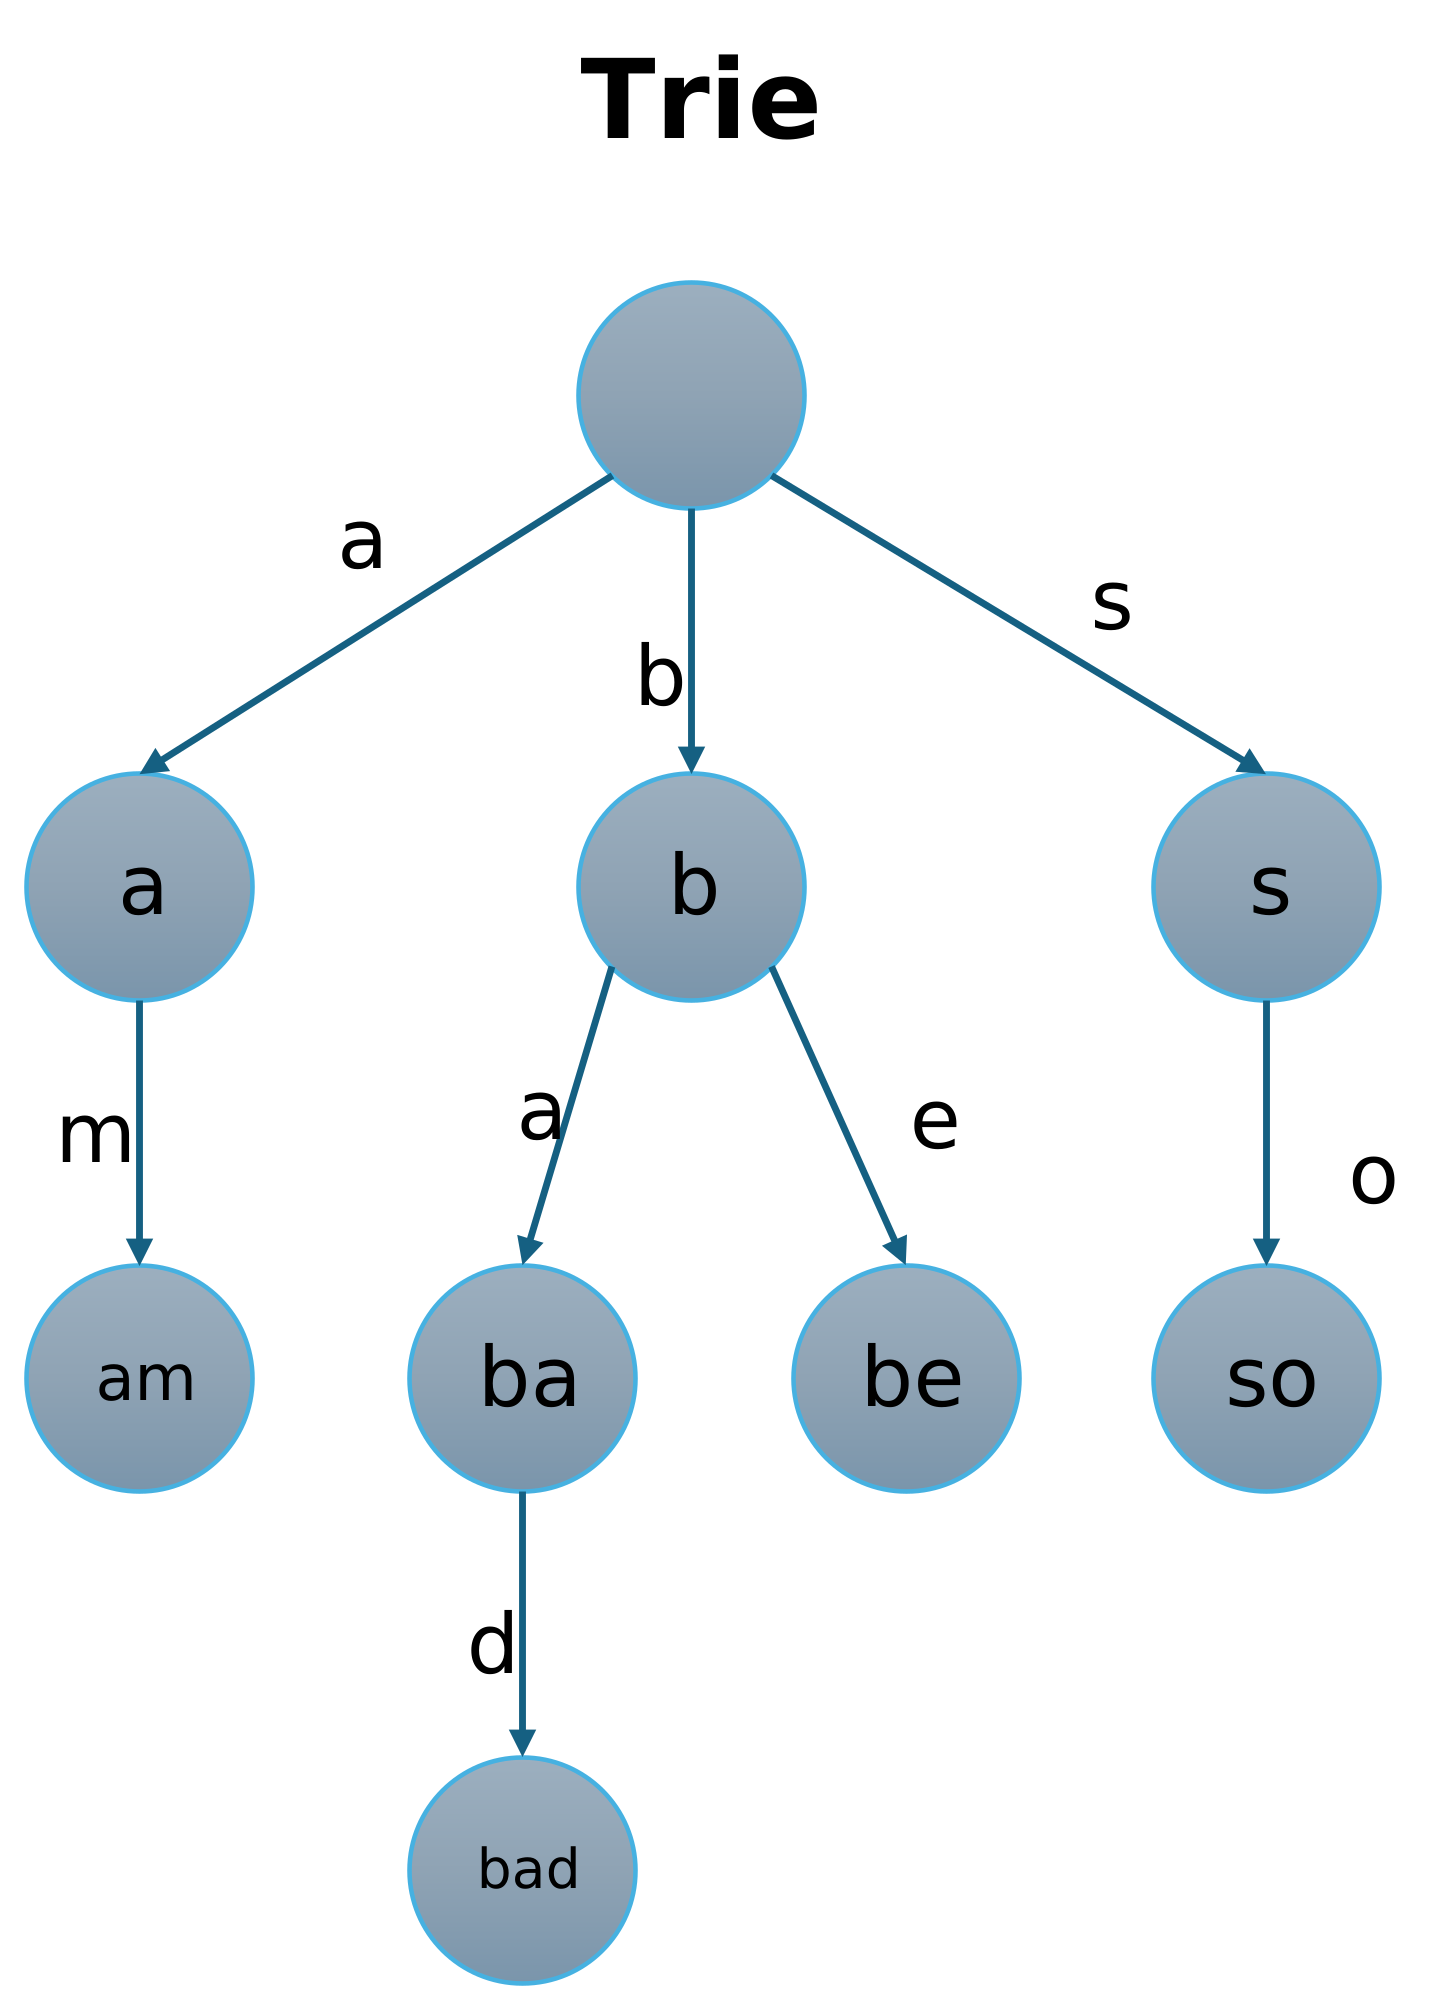
trie 非常适合用来做敏感词过滤
参考我的其他文章:
图
为什么?
- 如果我们的工作可以诠释成graph,那么我们至少接近解决方案了。如果能诠释成tree,那么已经拥有一个解决方案了
- 例如,XML文档或目录结构都是tree
- 例如,机器学习中的决策树也是tree,而神经网络一般是graph
图的基本定义
【定义】图 Graph:一个图是一个三元组,$(V,E,\phi)$,其中 V是节点(verticle)的集合,E是边(edge)的集合,函数 $\phi$ 是从边集合到节点的无序偶(有序偶)上的函数。
- $\phi$ 把边 $e_i$ 映射到无序偶 $(v_j, v_k)$,这条边叫做 无向边
- $\phi$ 把边 $e_i$ 映射到有序偶 $<v_j, v_k>$,这条边叫做 有向边
- 一个图所有的边都是无向边,叫做 无向图
- 一个图所有的边都是有向边,叫做 有向图
- 加权图:每条边有某种权值
其它定义
- 节点的 度(degree):节点v所在边的个数,
- 节点的 邻居 (neighbor):相同边连接的节点
- 从 i 到 j 的 路径(path)是指从 i 到达 j 的边的序列。
- 图的 直径(diameter) 是指连接任意两个节点的所有最短路径中最长路径的长度。
- 测地路径(geodesic path)是指两个节点之间的最短路径。
- $v_i,v_j$ 之间可以有多条边,它们叫做 平行边
- 如果一个图含有平行边,这个图叫做 多重图
一些特殊的图:
- 完全图(complete)。任意两点之间都存在边
- 定理: 一个完全图有n个节点,那么有 $n(n-1)/2$ 条边
- 连通图(connected)。任意两点之间都存在路径。
- 如果可以回到一个给定节点,则该图是 有环图(cyclic)。相对地,如果至少有一个节点无法回到,则该图就是 无环图(acyclic)
- 无向的无环图叫做 森林(Forest)
- 连通的森林叫做 树
- Forest可以由一个或多个tree构成
定理
- 一个图中,节点的度之和,等于边数的两倍。证明:一个边必然对应两个节点,造成两个度
- 一个图中,度数为奇数的节点必然是偶数个。证明:用上面这条。
对于有向(directed)图:
- i 的入度(in-degree)是指向 i 的边的数量
- 出度(out-degree)是远离 i 的边的数量。
- 【定理】 入度之和等于出度之和
关于补图和子图:
【定义】子图: $H=(W,F)$是$G=(V,E)$的子图,如果$W \subseteq V,F \subseteq E$
【定义】补图: 一个图G,有G所有节点和所有能使G称为完全图的添加边所组成的图,叫做 G 的补图
【定义】相对补图: $G_1=(V_1,E_1)$ 是 $G=(V, E)$ 的子图,如果 有 $G_2=(V_2, E_2)$,其中 $E_2=E-E_1$,$V_2$ 是与 $E_2$ 有关的节点,那么叫做 $G_2$ 是 $G_1$ 相对 $G$ 的补图
关于图的同构
同构 的定义:给定两个简单图 $G = (V, E), G_1 = (V_1, E_1)$,如果满足以下条件,称为这两个图同构
- 存在一一映射 $g:V\to V_1$
- 边 $(v_i, v_j) \in E$ 当且仅当 $(g(v_i), g(v_j))\in E_1$ (对于有向图有对应的形式)
定理: 容易证明,同构具有反身性、对称性、传递性
定理:两个简单图同构,当且仅当它们的补图也同构。
定理 两个图同构的必要条件(不是充分条件)
- 结点数量相同
- 边数相同
- 度数相同的结点数目相同
【定义】自补 :如果一个图同构于它的补图,那么称这个图是自补的
关于连通图:
- 路径 是这样的子图,边是连续连接节点构成的
- 路径终点上添加一条指向起点的边,构成一条
环路(cycle) 路径的长度:路径上各边权重的和。如果是无权图,每个边的权重视为1.
【定理】 一个图有 n 个节点,如果 $v_i, v_j$ 之间有路径,那么存在一个路径,其长度不多于 n-1
连通
- 【定义】连通 无向图中,如果两个节点 $v_i, v_j$ 之间有路径,称它们是连通的。
- 【定义】连通子图
- 【定义】连通图 如果一个图只有一个连通子图,称为连通图
- 【定义】连通分量 最大连通子图的个数
- 【定理】 如果一个图含有n个顶点和k条边,那么至少它有n-k个连通分量。(证明:对k做归纳法)
【定义】点割集 无向图 $G = (V, E)$ 是连通图,若一个点集 $V_1$,使得图 G 删除 $V_1$ 所有节点后,所得的子图是不连通的,而删掉任意 $V_1$ 的真子集后,所得子图仍然是连通图。称 $V_1$ 是点割集。如果 $V_1$ 中只有一个元素,称这个点是 割点 - 点割集可以有多个,定义数量最少的那个点割集,其数量为 点连通度 $k(G)$. 它其实是把一个连通图变成不连通图,至少要删掉多少个点
【定义】边割集 定义类似上面的点割集。类似也有定义 边连通度
【定理】 一个无向图 G 中的节点 v 是割点的充分必要条件是存在两个节点 $u, w$ 使得 $u, w$ 的每一条路都通过 v
- 割边
- 这样的边:如果删除,连通分量的个数将增加1
TH:一条边是割边当且仅当它不属于任何一个环
【定义】有向图的连通情况
- 对于所有节点对,至少某一个方向可达,称为 单侧连通
- 对于所有节点对,都双向可达,称为 强连通
【定理】 一个有向图是强连通的,当且仅当 G 中有一个这样的回路,它至少包含每个节点一次。
图的表示
图的表示方法
- 邻接表:使用 list、set、dict 等数据结构组合实现
- 无权图:
list-set,list-list - 有权图:
list-dict,dict-dict
- 无权图:
- 边列表,是一个list,每个元素为
[(weight, source, target), ...]三元组表示。- 对于无权图,则省略为二元组
[(source, target), ...]
- 对于无权图,则省略为二元组
- 邻接矩阵
- 链表表示
- 点边矩阵表示
邻接表(无权图)
# list-set 表示,访问时间为 O(1)
v1, v2, v3, v4, v5, v6, v7, v8 = range(8)
N = [
    {v2, v3, v4, v5, v6}, # v1
    {v3, v5},             # v2
    {v4},                 # v3
    {v5},                 # v4
    {v6},                 # v5
    {v3, v7, v8},         # v6
    {v6, v8},             # v7
    {v6, v7},             # v8
]

# 用法
v2 in N[v1]  # Neighborhood membership
len(N[f])  # Degree


# list-list 表示
v1, v2, v3, v4, v5, v6, v7, v8 = range(8)
G = [
    [v2, v3, v4, v5, v6],  # v1
    [v3, v5],              # v2
    [v4],                  # v3
    [v5],                  # v4
    [v6],                  # v5
    [v3, v7, v8],          # v6
    [v6, v8],              # v7
    [v6, v7],              # v8
]
邻接表(有权图)
# list-dict 表示
v1, v2, v3, v4, v5, v6, v7, v8 = range(8)
G = [
    {v2: 2, v3: 1, v4: 3, v5: 9, v6: 4},  # v1
    {v3: 4, v5: 3},                      # v2
    {v4: 8},                             # v3
    {v5: 8},                             # v4
    {v6: 7},                             # v5
    {v3: 2, v7: 2, v8: 2},               # v6
    {v6: 1, v8: 6},                      # v7
    {v6: 9, v7: 8},                      # v8
]

# 用法
v2 in G[v1]   # 判断边 v1 → v2 是否存在
len(G[v6])    # v6 的出度(Out-degree)
G[v1][v2]     # 边 v1 → v2 的权重(Edge Weight)


# dict-dict 表示
v1, v2, v3, v4, v5, v6, v7, v8 = range(8)
G = {
    v1: {v2: 2, v3: 1, v4: 3, v5: 9, v6: 4},
    v2: {v3: 4, v5: 3},
    v3: {v4: 8},
    v4: {v5: 8},
    v5: {v6: 7},
    v6: {v3: 2, v7: 2, v8: 2},
    v7: {v6: 1, v8: 6},
    v8: {v6: 9, v7: 8},
}

# dict-dict 表示 转换为 “边列表” 表示
[(G[u][v], u, v) for u in G for v in G[u]]
图的邻接矩阵表示
v1, v2, v3, v4, v5, v6, v7, v8 = range(8)
A = [
    [0, 1, 1, 1, 1, 0, 1, 1],
    [1, 0, 1, 0, 1, 0, 1, 1],
    [0, 0, 0, 1, 1, 1, 1, 0],
    [1, 0, 0, 0, 1, 0, 0, 0],
    [0, 1, 1, 0, 0, 0, 1, 1],
    [1, 0, 1, 0, 0, 0, 0, 0],
    [1, 1, 0, 0, 0, 1, 0, 1],
    [1, 0, 1, 0, 1, 1, 1, 0],
]

# 用法
A[v1][v2]  # 判断边 v1 → v2 是否存在
sum(A[v6]) # v6 的出度(Out-degree)
性质
- 对于无向图来说,邻接矩阵是对称矩阵。
- 判断节点相邻
O(1) - 计算顶点的度
O(n)
路径数量问题(结论对有向图、无向图都一样)
- 矩阵幂 $F = A^2$ 中的某个元素 $f_{ij}$ 指的是节点 i 到节点 j 的长度为 2 的路径的数量。(证明:用矩阵积的定义)
- 矩阵幂 $G = N^i$ 中的某个元素 $g_{ij}$ 指的是节点 i 到节点 j 的长度为 i 的路径的数量
为了考察节点之间的 可达性,注意到这个事实:
- 定理 如果图 G 中有 n 个节点,那么如果 i,j 之间有通路,那么肯定有一条通路,其长度 $l\leq n$
- 这个定理保证了,我们在考察节点可达性时,最多考虑 n 次幂即可。
定义可达矩阵 B,其中 $b_{ij} = 1$ 表示两个节点可达,$b_{ij} = 0$ 表示两个节点不可达。
- 就有这个结论 $B = bool(A + A^2 + … + A^n)$
- 上面的运算复杂度太高,其实我们只关心节点可达性,就定义一个相应的布尔幂即可(布尔幂就不多写了)
邻接矩阵:加权图
inf = float('inf')
v1, v2, v3, v4, v5, v6, v7, v8 = range(8)

A = [
    [0,   111, 88,  96,  116, 102, 71,  176],
    [inf, 0,   32,  19,  inf, inf, 64,  210],
    [110, 35,  0,   144, 108, 106, 35,  126],
    [inf, inf, inf, 0,   15,  38,  119, inf],
    [inf, inf, 58,  105, 0,   inf, 19,  inf],
    [148, inf, 143, inf, 44,  0,   154, 163],
    [49,  174, 68,  48,  258, 76,  0,   inf],
    [99,  143, 85,  159, 2,   44,  74,  0],
]

# 用法
A[v1][v2] < inf  # 判断边 v1 → v2 是否存在
A[v1][v2]        # 边 v1 → v2 的权重(Edge Weight)
sum(w < inf for j, w in enumerate(A[v5]) if j != v5)  # v5 的出度(Out-degree)
图的点边矩阵表示
对于无向图来说,点边矩阵是这样的
| e1 | e2 | e3 | e4 | e5 | |
|---|---|---|---|---|---|
| v1 | 1 | 0 | 0 | 1 | 0 |
| v2 | 1 | 1 | 0 | 0 | 1 |
| v3 | 0 | 1 | 1 | 0 | 0 |
| v4 | 0 | 0 | 1 | 1 | 1 |
例如,v2e5 和 v4e5 位置都是 1 ,这表示 v2v4 之间有一条标,这条边是 e5
一些性质
- 每一列只有 2 个 1
- 每一行的和是节点的度
- 如果某一行全0,这个节点是孤立节点
- 对于2个平行边来说,对应的两个列相同
对于有向图来说,点边矩阵是这样的
| e1 | e2 | e3 | e4 | e5 | |
|---|---|---|---|---|---|
| v1 | 1 | 0 | 0 | 1 | 0 |
| v2 | -1 | 1 | 0 | 0 | 1 |
| v3 | 0 | -1 | 1 | 0 | 0 |
| v4 | 0 | 0 | -1 | -1 | -1 |
例如, v1e1 位置为 1,v2e1 位置是 -1,这表示 v1到v2 有一条有向边,这条边是 e1
有类似的性质。
节点合并 图上的两个节点i, j 合并,对应的点边矩阵做如下操作,ij 这两行相加取模2 (这个结论对有向图、无向图都成立)
定理 一个连通图 G 有 r 个节点,那么对应的点边矩阵的秩是 r-1
- 点边矩阵每一行都有2个1,加到最后一列
随机生成一个联通图(Python),之后几个章节的算法也会用到这些函数
from random import Random
from math import dist


def generate_connected_graph(n, m, seed=42):
    """随机生成 n 个顶点、m 条边的无向无权连通图。
    图的数据结构为 list[tuple[int, int]]。
    """
    if not (n >= 1 and n - 1 <= m <= n * (n - 1) // 2):
        raise ValueError("顶点数或边数不合法")

    rng = Random(seed)

    # 1. 生成随机生成树,保证连通
    vertices = list(range(n))
    rng.shuffle(vertices)
    graph_edge_pairs = set()
    for i in range(1, n):
        u, v = vertices[i], rng.choice(vertices[:i])
        graph_edge_pairs.add((min(u, v), max(u, v)))

    # 2. 随机补充边
    remaining_edges = [
        (u, v)
        for u in range(n)
        for v in range(u + 1, n)
        if (u, v) not in graph_edge_pairs
    ]
    graph_edge_pairs.update(rng.sample(remaining_edges, m - n + 1))

    return sorted(graph_edge_pairs)


def generate_weighted_graph(n, graph_edge_pairs, seed=42):
    """输入:无向无权图。
    输出:顶点坐标、无向有权图。
    过程:随机生成顶点二维坐标,以欧氏距离作为边的权重。
    """
    rng = Random(seed)

    vertex_positions = [
        (rng.random(), rng.random()) for _ in range(n)
    ]
    graph_edge_weights = {
        (u, v): dist(vertex_positions[u], vertex_positions[v])
        for u, v in graph_edge_pairs
    }

    return vertex_positions, graph_edge_weights
画图:
# %% 画图
import matplotlib.pyplot as plt


def plot_graph(vertex_positions, graph_edge_weights, highlight_edges=(),
               *, distances=None, start=None, target=None,
               title="", save_path=None):
    """画原始图(灰色)、高亮边(红色),可标记起点终点和最短距离。"""
    fig, ax = plt.subplots(figsize=(7, 6))

    # 画 graph
    for u, v in graph_edge_weights:
        ax.plot(*zip(vertex_positions[u], vertex_positions[v]),
                color="gray", alpha=0.3, lw=1.5, zorder=1)

    # 画高亮部分的边
    for u, v, _ in highlight_edges:
        ax.plot(*zip(vertex_positions[u], vertex_positions[v]),
                color="tab:red", lw=3, zorder=2)

    #
    for u, (x, y) in enumerate(vertex_positions):
        color = "tab:green" if u == start else (
            "tab:orange" if u == target else "black")
        ax.scatter(x, y, color=color, s=55, zorder=3)
        label = str(u)
        if distances is not None:
            label += f"\n{distances[u]:.2f}"
        ax.text(x + 0.015, y + 0.015, label, fontsize=9)

    ax.set_title(title)
    ax.set_aspect("equal")
    ax.axis("off")
    fig.tight_layout()
    if save_path:
        fig.savefig(save_path, format="svg" if save_path.endswith(".svg") else None,
                    bbox_inches="tight")
    plt.show()
    plt.close(fig)
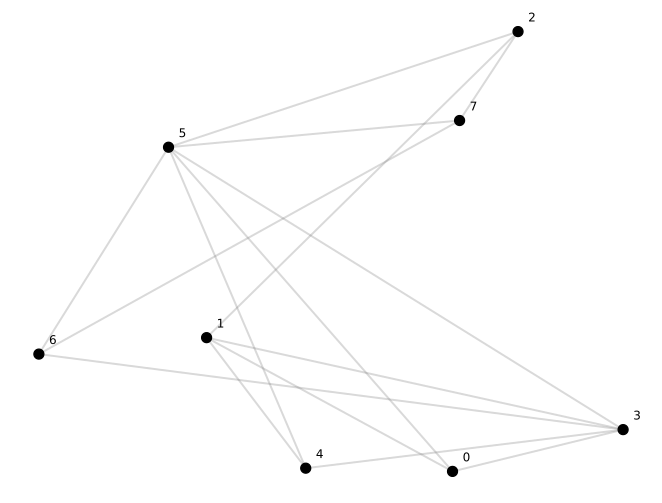
随机生成一个 graph,并 plot
# 随机生成一个无向无权联通图
graph_edge_pairs = generate_connected_graph(n=8, m=15, seed=42)
print("graph_edge_pairs:", graph_edge_pairs)

# 随机生成顶点二维坐标,以欧氏距离作为边的权重
vertex_positions, graph_edge_weights = generate_weighted_graph(n=8, graph_edge_pairs=graph_edge_pairs, seed=42)

# 画图
plot_graph(vertex_positions, graph_edge_weights)
结果:
[(0, 1), (0, 3), (0, 5), (1, 2), (1, 3), (1, 4), (2, 5), (2, 7), (3, 4), (3, 5), (3, 6), (4, 5), (5, 6), (5, 7), (6, 7)]
图的遍历
图的深度优先搜索:用stack,
图的广度优先搜索:用 queue
最小生成树
最小生成树问题(Minimum Spanning Tree Problem)是贪心算法中的一个著名问题。
- 最小生成树问题在 前面 解释过了
- 有哪些经典算法?Prim算法和Kruskal算法
Kruskal算法 可以得到最小生成树。其思路是,每个顶点各自构成一棵树,每次选取全局最小边(并且不构成回路的),并合并树。
- 选取最小的边 $e_i$ ,边数 i:=1
- i=n-1 结束,否则转到3
- 设已经选择的边是 $e_1, e_2, …, e_i$,那么选取这样的 $e_{i+1}$:
- $e_{i+1}$ 不同于 $e_1, e_2, …, e_i$
- $(e_1, e_2, …, e_i, e_{i+1})$ 不会构成回路
- $e_{i+1}$ 是满足以上条件的最小的边
- i:=i+1 转到2
注:第三步的前两条,是用 并查集 算法来实现的
Prim算法 也可以得到最小生成树。其思路是,从一个顶点开始,每次选取与其相邻的最近顶点(并且是尚未被选取的顶点),逐步扩展。
- 任意选择起点 $s$,初始化 $S={s}$
- 找到所有跨越 $S$ 与 $V\setminus S$ 的边
- 选择其中权重最小的一条边 $(u,v)$
- 把 $v$ 加入 $S$,并将 $(u,v)$ 加入生成树
- 重复3~4步骤,直到所有顶点都加入生成树。
注:步骤2~3,是靠维护一个 二叉堆(heap)实现的
| 比较维度 | Kruskal | Prim |
|---|---|---|
| 初始状态 | 每个顶点各自构成一棵树 | 一棵仅有起点的树 |
| 构造过程 | 多个连通分量逐渐合并 | 从一个顶点逐步扩展 |
| 贪心策略 | 在不构成环的边中,选取全局最小边 | 在跨越当前树边界的边中,选取最小边 |
| 防止环的方式 | 并查集,判断两个顶点是否已经在同一个集合中 | 维护一个 visited,只访问那些还没访问的顶点 |
| 核心数据结构 | 全局排序+并查集 | heap |
| 性能 | $O(E \log E)$ | $O(E \log V)$ |
| 通常适合 | 稀疏图 | 稠密图 |
这里的 UnionFind 见于前面的 并查集
# %% Kruskal 算法

#  转换为 Kruskal 适合的数据结构
def to_edges_list(graph_edge_weights):
    """边权字典 -> 边列表 (w, u, v)"""
    return [
        (w, u, v) for (u, v), w in graph_edge_weights.items()
    ]


def kruskal(n, graph_edges):
    """Kruskal:依次选择权重最小且不成环的边"""
    sorted_edges = sorted(graph_edges)

    uf = UnionFind(n)
    mst = []

    for w, u, v in sorted_edges:
        if uf.union(u, v):
            mst.append((u, v, w))
            if uf.component_count == 1:
                break

    if len(mst) != n - 1:
        raise ValueError("图不连通")
    return mst


# %% Prim 算法

from heapq import heapify, heappop, heappush

# 转化为 Prim 算法所需要的数据结构
def to_adjacency_list(n, graph_edge_weights):
    """边权字典 -> 双向邻接表"""
    graph_adjacency = [[] for _ in range(n)]
    for (u, v), w in graph_edge_weights.items():
        graph_adjacency[u].append((v, w))
        graph_adjacency[v].append((u, w))
    return graph_adjacency


def prim(graph_adjacency, start=0):
    """Prim:每次选取连接已访问与未访问顶点的最小边"""
    visited = {start}
    heap = [(w, start, v) for v, w in graph_adjacency[start]]
    heapify(heap)
    mst = []

    while heap and len(mst) < len(graph_adjacency) - 1:
        w, u, v = heappop(heap)
        # v 已经在当前树中,只 pop,并进入下一轮迭代
        if v in visited:
            continue

        visited.add(v)
        mst.append((u, v, w))

        # 把新加入的顶点,其相邻的、未访问的顶点加入堆,作为下一次迭代的候选
        for nxt, weight in graph_adjacency[v]:
            if nxt not in visited:
                heappush(heap, (weight, v, nxt))

    if len(mst) != len(graph_adjacency) - 1:
        raise ValueError("图不连通")
    return mst


# %% 执行算法
from math import isclose

n = 8
graph_edge_pairs = generate_connected_graph(n=n, m=15, seed=42)
print("graph_edge_pairs:", graph_edge_pairs)

vertex_positions, graph_edge_weights = generate_weighted_graph(n=8, graph_edge_pairs=graph_edge_pairs, seed=42)

graph_edges = to_edges_list(graph_edge_weights)
graph_adjacency = to_adjacency_list(n, graph_edge_weights)

mst_kruskal = kruskal(n, graph_edges)
mst_prim = prim(graph_adjacency, start=0)
weight_k = sum(w for _, _, w in mst_kruskal)
weight_p = sum(w for _, _, w in mst_prim)
assert len(mst_kruskal) == len(mst_prim) == n - 1
assert isclose(weight_k, weight_p)
print(f"Kruskal MST 总权重: {weight_k:.6f}")
print(f"Prim MST 总权重:    {weight_p:.6f}")

plot_graph(vertex_positions, graph_edge_weights, mst_kruskal,
           title="Kruskal MST", save_path="mst_kruskal.svg")
plot_graph(vertex_positions, graph_edge_weights, mst_prim,
           start=0, title="Prim MST", save_path="mst_prim.svg")
Kruskal MST 总权重: 2.387558
Prim MST 总权重: 2.387558
| Kruskal | Prim |
|---|---|
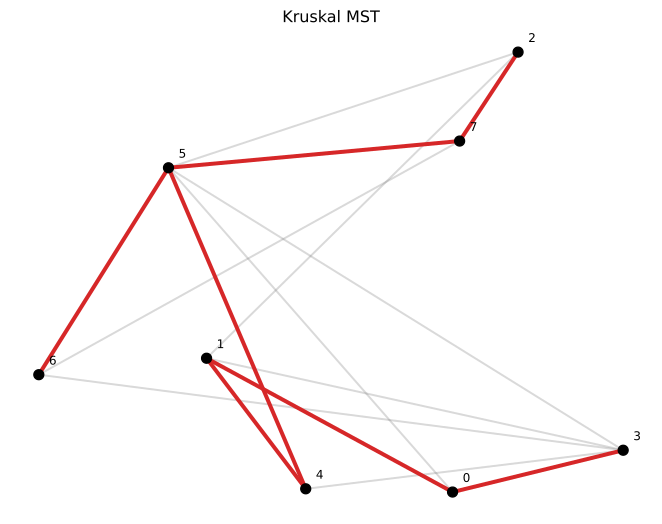 |
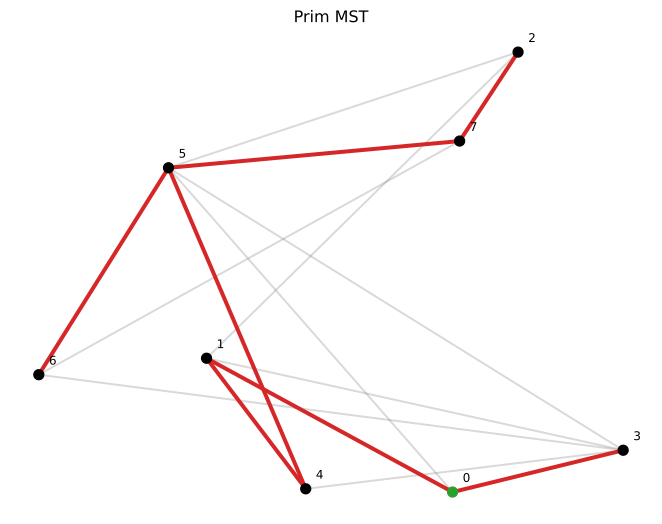 |
最短距离
| 对比维度 | Dijkstra | Floyd–Warshall |
|---|---|---|
| 解决的问题 | 某个顶点到其它所有顶点的最短距离 SSSP Single-Source Shortest Paths |
所有顶点对最短路径 APSP All-Pairs Shortest Paths |
| 核心思想 | 贪心(Greedy) | 动态规划(Dynamic Programming) |
| 时间复杂度 | $O((V+E)\log V)$ | $O(V^3)$ |
| 支持负权边 | 不支持 | 支持,但不能有负权环 |
Dijkstra 算法步骤:
- 初始化
D[k] = A[v0,k],是一个 N 维度数组,代表 v0 到 vk 的最短距离 - 初始化
S = {v0,}代表已经找到最短路径的顶点的集合 - 找到 $x = \arg\min\limits_{k \in V-S} D[k]$,然后把 x 加入 S 中
- 如果
D[x] = inf,则剩余的所有顶点都不可达,算法结束
- 如果
- 对每一个
V - S中的顶点I,重新计算最优距离D(I) = min(D(I),D(x)+A(x,I)) - 回到3,直到
V-S为空
from math import inf


def dijkstra(graph_adjacency, start=0):
    """单源最短路径:返回距离列表、前驱列表 parent[v]=(u, w)。"""
    n = len(graph_adjacency)
    if not 0 <= start < n:
        raise ValueError("起点不合法")
    if any(w < 0 for neighbors in graph_adjacency for _, w in neighbors):
        raise ValueError("Dijkstra 不支持负权边")

    distances = [inf] * n
    parent = [None] * n
    distances[start] = 0.0
    heap = [(0.0, start)]

    while heap:
        d, u = heappop(heap)
        if d > distances[u]:  # 跳过过时的候选距离
            continue
        for v, w in graph_adjacency[u]:
            new_d = d + w
            if new_d < distances[v]:
                distances[v] = new_d
                parent[v] = (u, w)
                heappush(heap, (new_d, v))
    return distances, parent


def shortest_path_edges(parent, start, target):
    """从前驱列表还原起点到目标点的最短路径边。"""
    edges = []
    v = target
    while v != start:
        if parent[v] is None:
            raise ValueError(f"顶点 {target} 不可达")
        u, w = parent[v]
        edges.append((u, v, w))
        v = u
    return edges[::-1]


def shortest_path_tree_edges(parent):
    """从前驱列表提取最短路径树的所有边。"""
    return [(u, v, w) for v, p in enumerate(parent)
            if p is not None for u, w in [p]]


# %% Floyd–Warshall
def floyd_warshall(graph_adjacency):
    """所有顶点对最短路径:返回距离矩阵与下一跳矩阵。时间 O(V^3)。

    next_hop[u][v] 表示从 u 前往 v 的某条最短路径上的第一个顶点。
    不可达时为 None。
    """
    n = len(graph_adjacency)
    distances = [[inf] * n for _ in range(n)]
    next_hop = [[None] * n for _ in range(n)]

    for u in range(n):
        distances[u][u] = 0.0
        next_hop[u][u] = u
        for v, w in graph_adjacency[u]:
            if w < distances[u][v]:
                distances[u][v] = w
                next_hop[u][v] = v

    for k in range(n):
        for i in range(n):
            if distances[i][k] == inf:
                continue
            for j in range(n):
                new_distance = distances[i][k] + distances[k][j]
                if new_distance < distances[i][j]:
                    distances[i][j] = new_distance
                    next_hop[i][j] = next_hop[i][k]

    if any(distances[i][i] < 0 for i in range(n)):
        raise ValueError("图中存在负权环,最短路径未定义")

    return distances, next_hop


def floyd_path_vertices(next_hop, start, target):
    """通过下一跳矩阵还原 start 到 target 的最短路径顶点序列。"""
    n = len(next_hop)
    if not (0 <= start < n and 0 <= target < n):
        raise ValueError("顶点编号不合法")
    if next_hop[start][target] is None:
        raise ValueError(f"从 {start} 到 {target} 不可达")

    path = [start]
    u = start
    while u != target:
        u = next_hop[u][target]
        path.append(u)
    return path


def path_vertices_to_edges(path, graph_edge_weights):
    """将顶点路径转换为绘图统一格式 (u, v, w);适用于无向图。"""
    edges = []
    for u, v in zip(path, path[1:]):
        w = graph_edge_weights.get((u, v), graph_edge_weights.get((v, u)))
        if w is None:
            raise ValueError(f"路径包含原始图中不存在的边 ({u}, {v})")
        edges.append((u, v, w))
    return edges

#%%
from math import isclose

n = 8
graph_edge_pairs = generate_connected_graph(n=n, m=15, seed=42)
print("graph_edge_pairs:", graph_edge_pairs)

vertex_positions, graph_edge_weights = generate_weighted_graph(n=8, graph_edge_pairs=graph_edge_pairs, seed=42)

graph_edges = to_edges_list(graph_edge_weights)
graph_adjacency = to_adjacency_list(n, graph_edge_weights)

distances, parent = dijkstra(graph_adjacency, start=0)
spt_edges = shortest_path_tree_edges(parent)
path_edges = shortest_path_edges(parent, 0, 7)
assert len(spt_edges) == n - 1
assert isclose(sum(w for _, _, w in path_edges), distances[7])
print(f"Dijkstra 0 -> 7 最短距离: {distances[7]:.6f}")
print("Dijkstra 0 -> 7 路径:", [0] + [v for _, v, _ in path_edges])

# Floyd–Warshall:所有点对最短距离 + 0 -> 7 最短路径
all_distances, next_hop = floyd_warshall(graph_adjacency)
floyd_vertices = floyd_path_vertices(next_hop, 0, 7)
floyd_edges = path_vertices_to_edges(floyd_vertices, graph_edge_weights)

# 对所有起点与 Dijkstra 逐个交叉校验
for source in range(n):
    dijkstra_distances, _ = dijkstra(graph_adjacency, start=source)
    assert all(isclose(a, b) for a, b in
               zip(all_distances[source], dijkstra_distances))

assert isclose(all_distances[0][7], distances[7])
assert isclose(sum(w for _, _, w in floyd_edges), all_distances[0][7])
print(f"Floyd 0 -> 7 最短距离: {all_distances[0][7]:.6f}")
print("Floyd 0 -> 7 路径:", floyd_vertices)

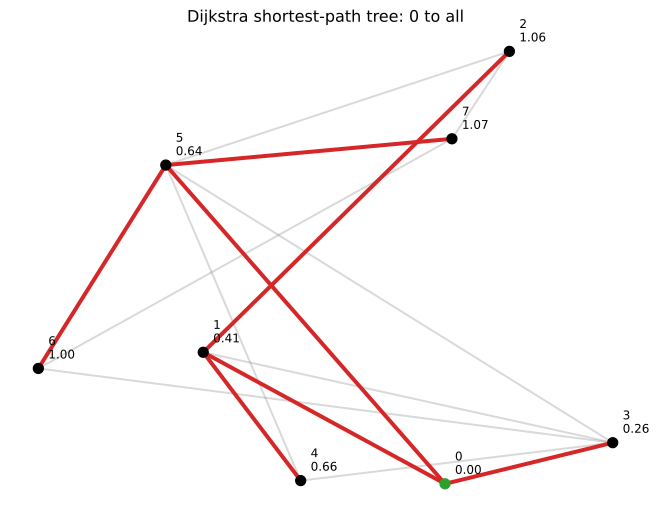
plot_graph(vertex_positions, graph_edge_weights, spt_edges,
           distances=distances, start=0,
           title="Dijkstra shortest-path tree: 0 to all", save_path="dijkstra_spt.svg")
plot_graph(vertex_positions, graph_edge_weights, path_edges,
           distances=distances, start=0, target=7,
           title="Dijkstra shortest path: 0 to 7", save_path="dijkstra_path.svg")
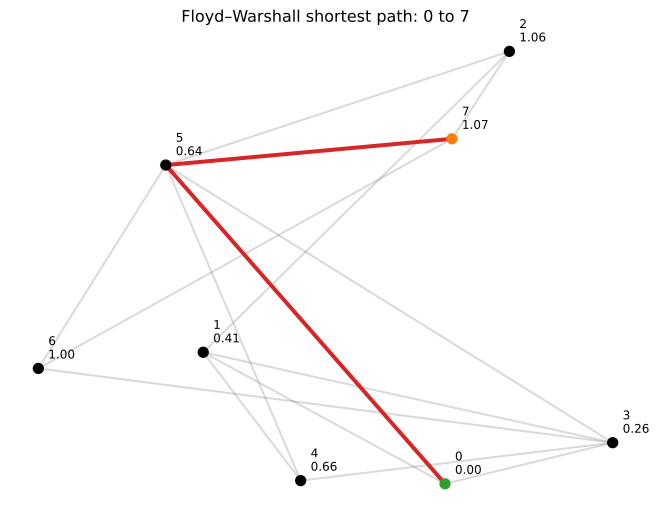
plot_graph(vertex_positions, graph_edge_weights, floyd_edges,
           distances=all_distances[0], start=0, target=7,
           title="Floyd–Warshall shortest path: 0 to 7",
           save_path="floyd_path.svg")
输出:
Dijkstra 0 -> 7 路径: [0, 5, 7]
Dijkstra 0 -> 0 最短距离: 0.000000
Dijkstra 0 -> 1 最短距离: 0.414812
Dijkstra 0 -> 2 最短距离: 1.061790
Dijkstra 0 -> 3 最短距离: 0.260229
Dijkstra 0 -> 4 最短距离: 0.657682
Dijkstra 0 -> 5 最短距离: 0.638588
Dijkstra 0 -> 6 最短距离: 1.000328
Dijkstra 0 -> 7 最短距离: 1.071647
Floyd 0 -> 7 最短距离: 1.071647
Floyd 0 -> 7 路径: [0, 5, 7]
| Dijkstra | Dijkstra 0 到所有顶点的最小距离 | Floyd |
|---|---|---|
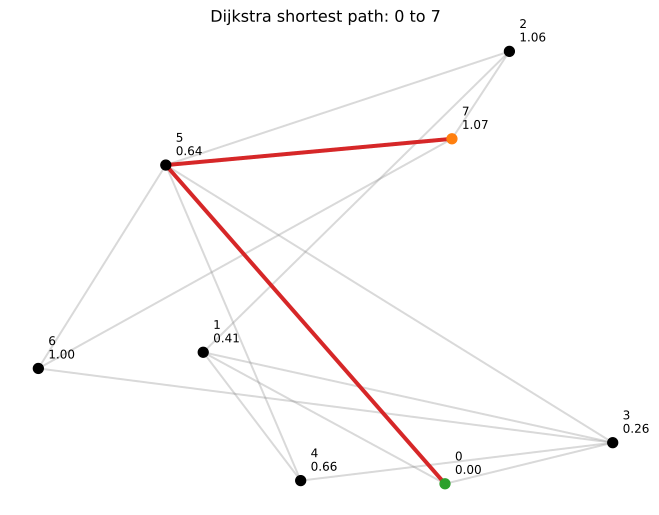 |
 |
 |
其它经典问题
TSP 旅行商问题:https://www.guofei.site/2016/10/05/ga.html
AOV 网络与拓扑排序:把一个网状的任务依赖顺序,变成一个线性的排序
您的支持将鼓励我继续创作!